 Oh-My-Note
为什么用 LangChain 而不是官方 SDK
从官方示例起步
让我们从openai的官方 SDK 开始,了解大模型官方 sdk 是如何调用的。
这是一次单轮对话的 api 调用示例:
javascript1import OpenAI from 'openai'
2
3const client = new OpenAI({
4  apiKey: process.env.API_KEY,
5  baseURL: 'https://api.deepseek.com',
6})
7
8async function main(): Promise<void> {
9  const response = await client.chat.completions.create({
10    model: 'deepseek-chat',
11    messages: [
12      { role: 'system', content: '你是一个乐于助人的助手。' },
13      { role: 'user', content: '你好!' },
14    ],
15    stream: false,
16  })
17  console.log(response.choices[0].message.content)
18}
19
20main()
这段代码干净清晰,跑通 demo 没有问题。然而当功能需求多起来后,这套写法完全支撑不住。
弊端详解
1. 上下文手动维护
模型本身是无状态的,每次调用只知道本轮传入的 messages。想要多轮对话,就必须在应用层自己维护一个messages数组,每次请求都把完整历史塞进去。
这件事听起来很简单,我把messages数组保存下来,每次调用模型都去请求完整的messages传给大模型不就好了吗?
但这样做会遇到问题:
- 对话轮次越多,
messages数组越长,token成本飙升,花费飙涨。 - 超出模型上下文窗口(以 DeepSeek 为例是 64K)时,请求直接失败
- 到底保留多少历史?超限时怎么截断?要不要做摘要压缩?这些全要你自己决定
一旦对话超过几十轮,这套手动维护的方式就会失控。截断策略、摘要压缩、滑动窗口,这些记忆管理的职责被完全推给了开发者。
2. 更换模型就要换代码
从 DeepSeek 切到 OpenAI、Claude 或智谱时,需要改 baseURL、model 名,有时还要换整个 SDK,甚至重写返回格式的解析逻辑。以不同服务商的差异汇总为例:
| 参数 | DeepSeek | OpenAI | Claude |
|---|---|---|---|
baseURL | https://api.deepseek.com | https://api.openai.com | https://api.anthropic.com |
model 名 | deepseek-chat | gpt-4.5 | claude-3-7-sonnet-latest |
| SDK 包名 | openai | openai | @anthropic-ai/sdk |
| 返回内容字段 | choices[0].message.content | choices[0].message.content | content[0].text |
实际项目里,调用通常散落在多个文件里,换一次模型就要全局搜索替换。如果同时想支持"主力模型 + 备用模型"的切换逻辑,代码会迅速臃肿,且极易遗漏某处。
3. 提示只能硬编码
system 和 user 的内容直接写死在代码里,没有任何管理机制:
js1import type { ChatCompletionMessageParam } from 'openai/resources/chat'
2
3const messages: ChatCompletionMessageParam[] = [
4  { role: 'system', content: '你是一个乐于助人的助手。' },
5  { role: 'user', content: '你好!' },
6]
现实中一个稍微复杂点的应用,可能需要客服、翻译、代码助手等多个角色,每套角色对应不同的系统提示。这些内容全部写死在代码里,改一处就要重新部署,历史版本也无从追溯。
更大的问题是无法做 A、B 测试。要对比两套提示的效果,要么复制一份代码手动切换,要么加一堆条件分支。上线后发现哪个版本效果更好,往往也说不清楚。
4. 无法调用外部工具
API 只接受文本、返回文本,不能查天气、不能搜数据库、不能执行计算。想做 Agent 或 RAG,全靠自己封装 HTTP 调用和解析逻辑。
典型场景:
- 用户问"北京今天天气怎么样?",模型只能靠训练数据猜测,无法调实时天气
API - 用户问"我们公司上季度销售额多少?",模型看不到数据库,无法查询
- 用户问"帮我算一下 12345 × 67890",复杂计算依赖外部工具时,光靠
prompt引导并不可靠
要把 LLM 和外部工具打通,需要自己设计并实现完整的 Agent 流程: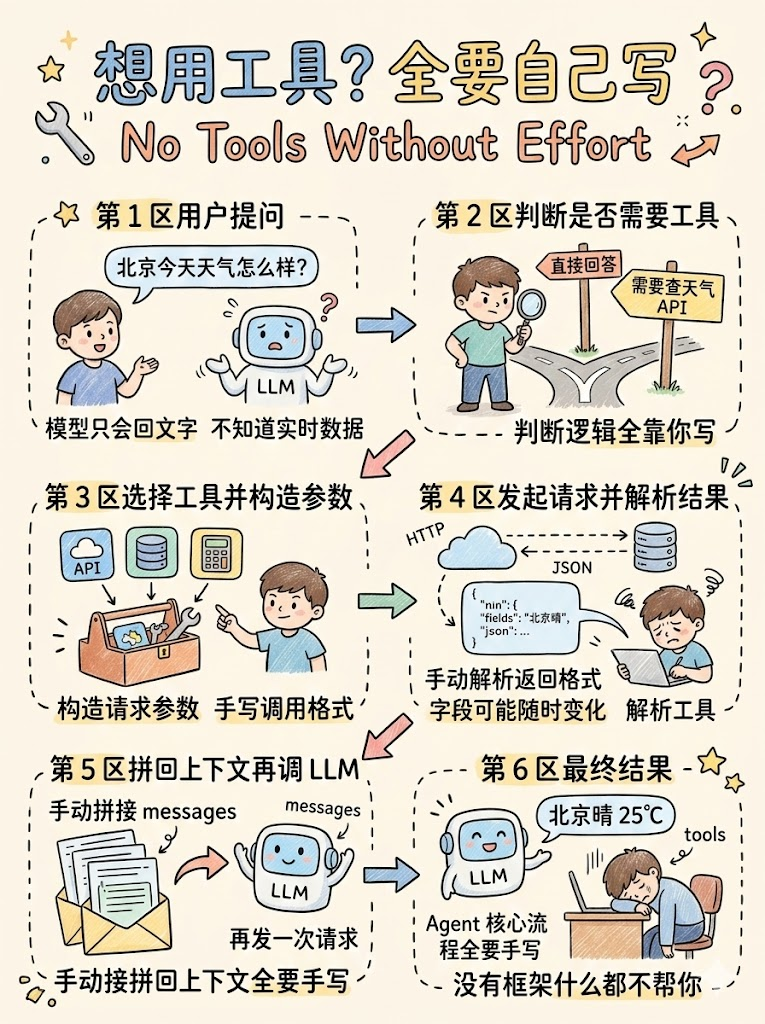
图中每一个环节都需要开发者手写:判断是否需要工具、选择哪个工具、构造调用参数、发起 HTTP 请求、解析返回结果、拼回 messages、再次调用 LLM。这恰好是 Agent 的核心逻辑,裸调 API 完全不管。
5. 错误处理、重试、超时都要自己写
网络抖动、限流、模型过载、token 超限等异常,官方示例里通常不涉及,生产环境却必须考虑。
常见问题包括:
- 网络超时,需设置
timeout,实现有边界的重试逻辑 - 限流(429 错误),需退避重试,通常要做指数退避
- 模型过载(503 错误),需排队或切换备用模型
token超限,需截断输入或提示用户缩短问题API Key失效,需友好提示和fallback机制
这还只是最基础的限流重试,没有覆盖超时、备用模型、熔断等场景。完整的生产级错误处理远比这复杂,而这些全是业务逻辑之外的基础设施工作。
6. 流式输出自己处理
若设 stream: true,返回的是 SSE(Server-Sent Events)流,需自己遍历异步迭代器、拼接字符串、处理断开重连:
javascript1import OpenAI from 'openai'
2
3const client = new OpenAI({
4  apiKey: process.env.DEEPSEEK_API_KEY,
5  baseURL: 'https://api.deepseek.com',
6})
7
8const stream = await client.chat.completions.create({
9  model: 'deepseek-chat',
10  messages: [{ role: 'user', content: '写一首诗' }],
11  stream: true,
12})
13
14for await (const chunk of stream) {
15  const content = chunk.choices[0]?.delta?.content
16  if (content) {
17    process.stdout.write(content)
18  }
19}
在 Node.js 脚本里打印还好说,一旦需要把流式结果推给前端,就涉及 WebSocket 或 SSE 通道的管理、前端的渲染更新、中途断流的重连策略,以及如何在流式输出结束后触发后续逻辑(比如保存对话记录)。这些在官方示例里通常一笔带过。
总结
把以上六个问题汇总来看,裸调 API 把所有编排职责都推给了开发者,每一条单独来看都不是无法解决的问题,但六条加在一起,加上日后维护和扩展的成本,很快就会让代码变成一个难以维护的大泥球。LangChain 把这些能力封装成可复用组件,让开发者把精力放在业务逻辑上,而不是重复造基础设施。
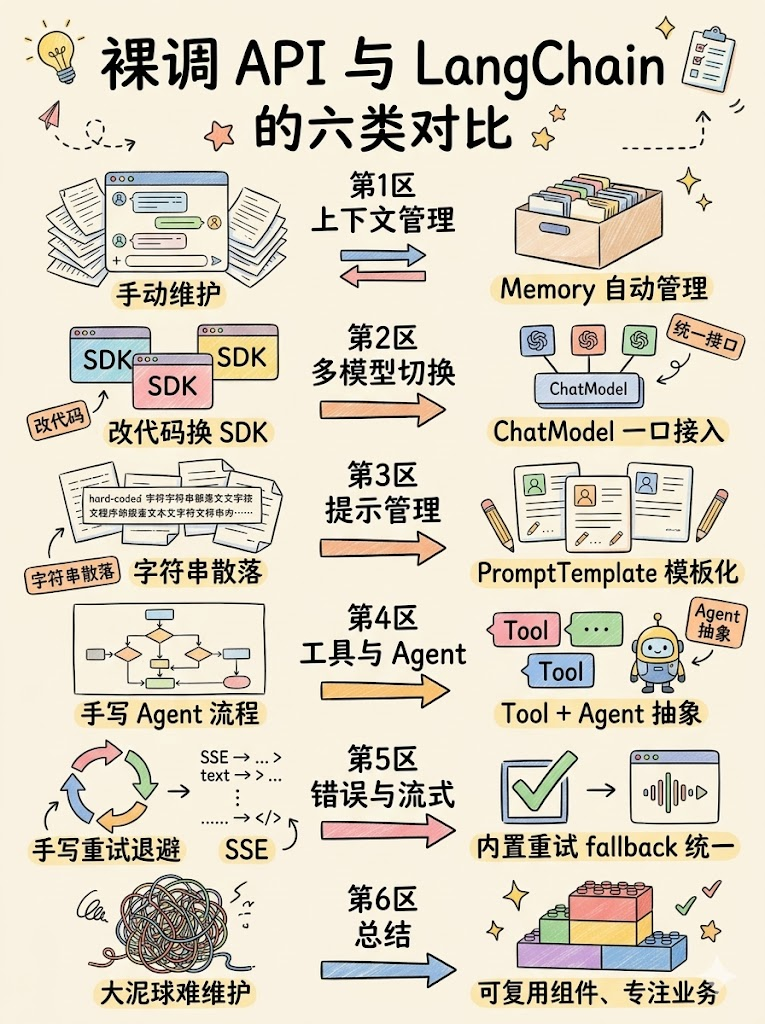
一图概括裸调 API 与 LangChain 在上下文、多模型、提示、工具、错误与流式六方面的对比,以及从大泥球到可复用组件的差异。
简单来说 LangChain 就是一套提供更丰富的扩展性,更简单的维护的 LLM 模型调用框架,它在内部帮我们做了很多自动档的事情,让我们更专注于业务。