 Oh-My-Note
响应系统
1.1 响应式数据和副作用函数
副作用函数指的是会产生副作用的函数:
js1function effect() {
2  document.body.innerText = 'hello world'
3}
当 effect 函数执行时,它会设置 body 的文本内容,但除了 effect 函数外的任何函数都可以读取或者设置 body 的文本内容。也就是说,effect 函数的执行会直接或者间接影响到其他函数的执行,这时 effect 产生了副作用。
副作用很容易产生,比如我们一个函数修改了全局变量,这也是一个副作用。
js1// 全局变量
2let global = 1
3
4function effect() {
5  global = 2 // 修改全局变量,产生了副作用
6}
响应式数据指的是会让副作用函数重新执行的数据。
例如下面有一个副作用函数读取了某个对象的值:
js1const obj = { text: 'hello world' }
2function effect() {
3  document.body.innerText = obj.text
4}
当 obj.text 发生变化时,我们希望副作用函数 effect 会重新执行:
js1obj.text = 'hello vue' // 修改 obj.text后,副作用函数会重新执行
如果 obj.text 的值发生了变化,副作用函数真的重新执行了,那么对象 obj 就是响应式数据。
1.2 响应式数据的基本实现
如何让 obj 变成响应式数据呢?通过观察我们可以得出两个线索:
- 副作用 effect 函数执行时,会触发读取 obj.text 的操作
- 当修改 obj.text 时,会触发字段 obj.text 的设置操作
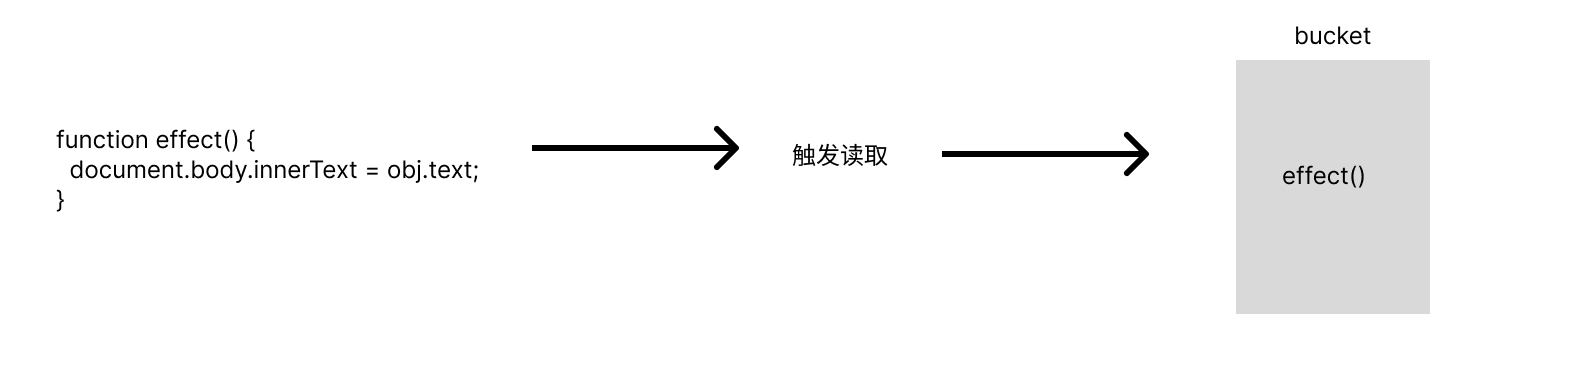
如果我们能拦截对象的读取和设置操作,事情就变得简单了。当读取字段 obj.text 时,我们可以将副作用函数 effect 存储到一个桶(bucket)里
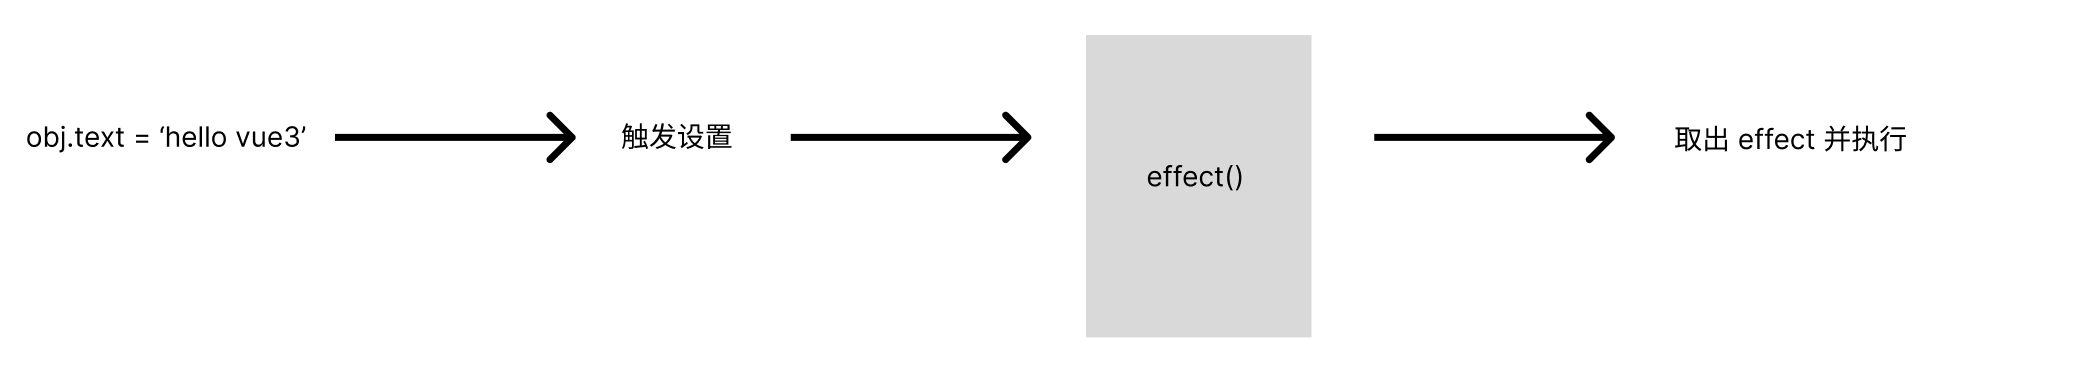
当设置 obj.text 时,从桶里拿出 effect 并执行即可。
现在的关键问题在于如何拦截对象的读取和设置操作。vue2 用的是 object.defineProperty 函数实现的,Vue3 则用的是 Proxy 代理对象。
js1const bucket = new Set()
2
3const data = { text: 'hello world' }
4const obj = new Proxy(data, {
5  // 拦截读取操作
6  get(target, key) {
7    // 将副作用函数存进桶里
8    bucket.add(effect)
9    return target[key]
10  },
11  // 拦截设置操作
12  set(target, key, newValue) {
13    //设置新的值
14    target[key] = newValue
15    // 从桶里取出副作用函数并执行
16    bucket.forEach((fn) => fn())
17    //返回 true 表示成功
18    return true
19  },
20})
下面我们使用一个副作用函数进行测试:
js1function effect() {
2  document.body.innerText = obj.text
3}
4
5effect()
6
7setTimeout(() => {
8  obj.text = 'hello vue' // 触发读取和设置设置操作
9}, 3000)
上面的代码会在 3 秒后将 body 的内容从 hello world 变成 hello vue 。
1.3 完善响应系统
上面的代码的逻辑非常简单:
- 读取操作时,将副作用函数存在桶里
- 设置操作时,将副作用函数从桶里拿出来执行
但是依然有不完善的地方,比如,我们硬编码了 effect 函数的名字,如果用户设置的副作用函数不叫 effect,那么响应系统就不能正确运行了。
为了让副作用函数可以是任意命名的函数,我们需要提供一个注册副作用函数的机制。
最简单的注册副作用函数的机制是这样的:
js1// 用全局变量来保存被注册的副作用函数
2let activeEffect
3// effect则用来注册副作用函数
4function effect(fn) {
5  activeEffect = fn
6  fn()
7}
这样,用户就可以传入一个函数来注册副作用函数:
js1effect(() => (document.body.innerText = obj.text))
当 effect 函数执行时,会把匿名函数赋值给全局变量 activeEffect。接着执行被注册的匿名副作用函数,这样也可以引发响应式数据 obj.text 的读取操作,此时会被 Proxy 对象拦截:
js1const obj = new Proxy(data, {
2  // 拦截读取操作
3  get(target, key) {
4    // 将保存在activeEffect 的匿名副作用函数存进桶里
5    if (activeEffect) bucket.add(activeEffect)
6    return target[key]
7  },
8  // 拦截设置操作
9  set(target, key, newValue) {
10    //设置新的值
11    target[key] = newValue
12    // 从桶里取出副作用函数并执行
13    bucket.forEach((fn) => fn())
14    //返回 true 表示成功
15    return true
16  },
17})
由于副作用函数已经储存到 activeEffect 中,所以在 get 拦截的时候把 activeEffect 收集到桶中,这样响应系统就不需要依赖函数的名字了。
现在虽然做到了不需要依赖函数名字,但是依然有 bug 存在。比如访问一个不存在的属性:
js1effect(() => {
2  console.log('effect run') // 执行了两次
3
4  document.body.innerText = obj.text
5})
6setTimeout(() => {
7  // obj.text = "hello vue";
8  obj.notExit = '123'
9}, 2000)
我们通过 log 台能够知道 effect 调用了两次。第一次是访问 obj.text 时,代理跟 effect 函数建立了响应联系。
第二次则是访问 obj.notExit 时,由于不存在这个属性,所以我们不需要访问这个属性时还会触发副作用函数,然而事与愿违,我们的代码逻辑是在 set 拦截时就触发副作用函数,不管之前有没有这个属性。这是不正确的。
要解决这个问题的根本在于,我们需要在 get 拦截时就让 effect 函数与被操作的目标字段之间建立某种联系。
仔细看代码就可以发现:
js1effect(function effectFn() => {
2  document.body.innerText = obj.text;
3});
这段代码中存在三个角色:
- 被操作的代理对象 obj
- 被操作的字段名 text
- 使用 effect 函数注册的函数 effectFn
如果我们用 target 表示被操作的代理对象,字段名作为 key,effectFn 作为被注册的副作用函数。我们可以为这三个角色建立如下关系:
target ├─ key ─ effectFn
现在,我们将 bucket 修改为 WeakMap 结构
js1let bucket = new WeakMap()
然后修改 get/set 拦截器的代码:
js1let obj = new Proxy(data, {
2  get(target, key) {
3    // 从桶里取得以当前对象为 key 的 depsMap,这是一个 Map 类型
4    let depsMap = bucket.get(target)
5    // 如果没有depsMap,那么就新建一个Map 并与 target 关联
6    if (!depsMap) {
7      bucket.set(target, (depsMap = new Map()))
8    }
9    // 根据 key 从 depsMap 中取得 deps
10    let deps = depsMap.get(key)
11    // 如果没有则新建一个 Set 类型并与 key 关联
12    if (!deps) {
13      depsMap.set(key, (deps = new Set()))
14    }
15    // 将当前激活的副作用函数添加到桶里
16    deps.add(activeEffect)
17    return target[key]
18  },
19  set(target, key, newValue) {
20    // 设置属性值
21    target[key] = newValue
22    // 根据 target 从桶里取出 depsMap
23    const depsMap = bucket.get(target)
24    if (!depsMap) return
25    // 再根据 key 从 depsMap 中取得注册的所有副作用函数依赖集合
26    const effects = depsMap.get(key)
27    // 执行副作用函数
28    effects && effects.forEach((effectFn) => effectFn())
29    return true
30  },
31})
从上面的代码可以看出我们目前的构建数据的方式是这样的:
- WeakMap 由 target --> Map 构成
- Map 由 key --> Set 构成
WeakMap 以 target 为键,值为一个 Map 实例。Map 以 target 的 key 为键,值为由副作用函数组成的 Set。
为了方便描述,我们将 Set 数据结构内的副作用函数集合称之为 key 的依赖集合。
为什么要用 WeakMap ?
以下面代码为例:
js1const map = new Map()
2const weakMap = new WeakMap()
3;(function () {
4  let foo = { foo: 1 }
5  let bar = { bar: 2 }
6  map.set(foo, 1)
7  weakMap.set((bar: 2))
8})()
map 以 foo 为键,weakMap 以 bar 为键。当匿名函数被执行后,map 中的对象 foo 依然被 map 的 key 所引用着,因此垃圾回收器不会将其回收;而 weakMap 的 key 是弱引用,它不会影响垃圾回收器的正常回收。所以当执行完毕后,对象 bar 会从内存中移除,并且我们无法从 weakMap 中获取对象 bar。
WeakMap 经常用于存储那些只有当 key 所引用的对象存在时才有价值的信息。如果 target 对象没有任何引用了,那么说明用户不需要用它了,这时垃圾回收器就会完成回收任务。如果用 Map 来收集 target 对象,那么即使用户的代码对 target 没有任何引用,这个 target 也不会被回收,最终可能导致内存溢出。
现在,我们将 get 拦截里的代码抽离成一个 track 函数,函数 track 用来表示追踪。将 set 拦截里的代码抽离成 trigger 函数,表示触发副作用函数。
js1let data = { text: 'hello world' }
2let bucket = new WeakMap()
3let activeEffect
4function effect(fn) {
5  activeEffect = fn
6  fn()
7}
8
9let obj = new Proxy(data, {
10  get(target, key) {
11    // 将副作用函数 activeEffect 添加到存储副作用函数的桶中
12    track(target, key)
13    // 返回属性值
14    return target[key]
15  },
16  set(target, key, newValue) {
17    // 设置属性值
18    target[key] = newValue
19    // 触发桶中的副作用函数
20    trigger(target, key)
21    return true
22  },
23})
24
25function track(target, key) {
26  // 从桶里取得以当前对象为 key 的 depsMap,这是一个 Map 类型
27  let depsMap = bucket.get(target)
28  // 如果 bucket 里面找不到  那么就新建一个Map 并与 target 关联
29  if (!depsMap) {
30    bucket.set(target, (depsMap = new Map()))
31  }
32  // 根据 key 从 depsMap 中取得 deps
33  let deps = depsMap.get(key)
34  // 如果没有则新建一个 set 类型
35  if (!deps) {
36    depsMap.set(key, (deps = new Set()))
37  }
38  // 将当前激活的副作用函数添加到桶里
39  deps.add(activeEffect)
40}
41
42function trigger(target, key) {
43  // 根据 target 从桶里取出 depsMap
44  const depsMap = bucket.get(target)
45  if (!depsMap) return
46  // 再根据 key 从 depsMap 中取得注册的所有副作用函数列表
47  const effects = depsMap.get(key)
48  // 执行副作用函数
49  effects && effects.forEach((effectFn) => effectFn())
50}
1.4 分支切换和 cleanup
什么是分支切换?
js1const data = { ok: true, text: 'hello world' }
2const obj = new Proxy(data, {})
3effect(() => {
4  document.body.innerText = obj.ok ? obj.text : 'not'
5})
effect接受的副作用函数中的代码会根据字段 obj.ok 的变化来执行不同的分支。这就是分支切换。
分支切换可能会产生遗留的副作用函数。比如,字段 obj.ok 初始值为 true 时,会读取 obj.text 的值,那么这时候就会触发 obj.ok 和 obj.text 两个读取操作,此时会往 bucket 中存入两个副作用函数。
data ├─ ok ─ effectFn ├─ text ─ effectFn
然而 obj.ok 为 false 时,effectFn 触发后并不会读取 obj.text ,那么理想情况下,effectFn 不会被 obj.text 对应的依赖集合所收集。
data ├─ ok ─ effectFn
不过按照现在的实现,即使将 obj.ok 修改为 false,并触发副作用函数重新执行,整个依赖关系并没有发生变化,这时就产生了遗留的副作用函数。
遗留的副作用函数会导致不必要的更新,举个例子:
js1obj.ok = false
现在我们已经将 obj.ok 修改成 false 了,按照之前的逻辑,obj.text 不会被读取。换句话说,即使 obj.text 怎么变,document.body.innerText 都是not,最好的结果是不需要再去执行 text 对应的副作用函数了。然而事实并非如此:
js1obj.text = 'vue'
这依然会导致副作用函数重新执行,即使视图层面已经不需要更新了。
解决的思路很简单,每次副作用函数执行时,我们都先把它从所有与之相关的依赖集合中删除。
当副作用函数执行完毕后,会重新建立联系,但在新的联系中不会包含遗留的副作用函数。所以如果我们能够做到每次在副作用函数执行前,都将其从相关联的依赖集合中删除,问题就迎刃而解了。
想要将副作用函数将相关联的依赖集合中删除,首先就必须知道哪些依赖集合中包含了该函数。
我们需要在副作用函数中设置一个数组来保存所有收集到的依赖集合。
js1// 用全局变量来保存被注册的副作用函数
2let activeEffect
3function effect(fn) {
4  const effectFn = () => {
5    // 当 effectFn 执行时,将其设置为当前激活的副作用函数
6    activeEffect = effectFn
7    fn()
8  }
9  // activeEffect.deps用来存储所有与该副作用函数相关联的依赖集合
10  effectFn.deps = []
11  effectFn()
12}
依赖集合可以在 track 函数中收集
diff1function track(target, key) {
2  // 从桶里取得以当前对象为 key 的 depsMap,这是一个 Map 类型
3  let depsMap = bucket.get(target);
4  // 如果 bucket 里面找不到  那么就新建一个Map 并与 target 关联
5  if (!depsMap) {
6    bucket.set(target, (depsMap = new Map()));
7  }
8  // 根据 key 从 depsMap 中取得 deps
9  let deps = depsMap.get(key);
10  // 如果没有则新建一个 set 类型
11  if (!deps) {
12    depsMap.set(key, (deps = new Set()));
13  }
14  // 将当前激活的副作用函数添加到桶里
15  deps.add(activeEffect);
16
17  // deps 就是一个与当前副作用函数存在联系的依赖集合
18  // 将其添加到 activeEffect.deps数组中
19+  activeEffect.deps.push(deps); // 新增
20}
在 track 函数中,我们将 activeEffect 添加到依赖集合 deps 中,这说明 deps 就是一个与当前副作用函数存在联系的依赖集合。此时我们也将它添加到 activeEffect.deps 中,此时就完成了对依赖集合的收集。
此时移除函数 cleanup 就好写了:
js1function cleanup(effectFn) {
2  for (let i = 0; i < effectFn.deps.length - 1; i++) {
3    // deps 是收集到的依赖集合
4    let deps = effectFn.deps[i]
5    // 从依赖集合中将副作用函数删除
6    deps.delete(effectFn)
7  }
8  // 重置effectFn.deps数组
9  effectFn.deps.length = 0
10}
最后在每次 effectFn 执行时就将副作用函数从依赖集合中删除。
js1function effect(fn) {
2  const effectFn = () => {
3    // 从依赖集合中清除 effectFn
4    cleanup(effectFn)
5    // 当 effectFn 执行时,将其设置为当前激活的副作用函数
6    activeEffect = effectFn
7    fn()
8  }
9  // activeEffect.deps用来存储所有与该副作用函数相关联的依赖集合
10  effectFn.deps = []
11  effectFn()
12}
此时还需要修改 trigger 中的代码,否则会引起 bug。
js1function trigger(target, key) {
2  // 根据 target 从桶里取出 depsMap
3  const depsMap = bucket.get(target)
4  if (!depsMap) return
5  // 再根据 key 从 depsMap 中取得注册的所有副作用函数列表
6  const effects = depsMap.get(key)
7  // 执行副作用函数
8  effects && effects.forEach((effectFn) => effectFn()) // 注意这段代码
9}
trigger 函数会执行 deps 中的 effectFn,而 effectFn 执行后又将其从 deps 中删除,然后 effectFn 函数中的代码document.body.innerText = obj.ok ? obj.text : "not"又会将 effectFn 往 deps 中塞。
根据 JS 的语言规范,在调用 forEach 遍历 Set 集合时,如果一个值已经被访问过,但该值被删除并重新添加到集合,如果此时 forEach 遍历没有结束,那么该值就会重新被访问。因此,上面的逻辑类似于以下代码,会无限被循环下去:
js1const set = new Set([1])
2set.forEach((item) => {
3  set.delete(item)
4  set.add(item)
5  console.log('遍历还未结束')
6})
解决办法是构造一个新的 Set ,并遍历它,代替直接遍历 effects,从而避免无限循环。
js1function trigger(target, key) {
2  // 根据 target 从桶里取出 depsMap
3  const depsMap = bucket.get(target)
4  if (!depsMap) return
5  // 再根据 key 从 depsMap 中取得注册的所有副作用函数列表
6  const effects = depsMap.get(key)
7  // 构造一个新的 Set 代替直接遍历 effects
8  const newEffects = new Set(effects)
9  newEffects.forEach((effectFn) => effectFn())
10  // effects && effects.forEach((effectFn) => effectFn());
11}
1.5 嵌套的 effect 和 effect 栈
effect 是可以嵌套的,例如:
js1effect(function effectFn1() {
2  effect(function effectFn2() {
3    // ...
4  })
5  //...
6})
effectFn1 的执行会触发 effectFn2 的执行。
在 Vue 中,渲染函数是在一个 effect 中执行的。
js1// Foo 组件
2const Foo = {
3  render() {
4    return /*...*/
5  },
6}
7// 在 effect 中执行 Foo 组件的渲染函数
8effect(() => {
9  Foo.render()
10})
当组件发生嵌套时,就会产生 effect 嵌套。
js1// Bar 组件
2const Bar = {
3  render() {
4    return /*...*/
5  },
6}
7// Foo 组件渲染了 Bar 组件
8const Foo = {
9  render() {
10    return <Bar />
11  },
12}
此时 effect 执行就相当于:
js1effect(() => {
2  Foo.render()
3  // 嵌套
4  effect(() => {
5    Bar.render()
6  })
7})
明白了为什么需要支持 effect 嵌套,我们来测试一下目前的响应系统对嵌套的支持情况:
js1let data = { foo: true, bar: true }
2let temp1, temp2
3let obj = new Proxy(data, {
4  /* 省略 */
5})
6effect(function effectFn1() {
7  console.log('effectFn1 执行')
8  effect(function effectFn2() {
9    console.log('effectFn2 执行')
10    temp2 = obj.bar
11  })
12  temp1 = obj.foo
13})
需要注意的是,我们在 effectFn2 中读取 obj.bar,在 effectFn1 中读取 obj.foo,并且 effectFn2 的执行要优先于 obj.foo 的读取操作。
理想情况下,我们希望的依赖关系是这样的:
data ├─ foo ─ effectFn1 ├─ bar ─ effectFn2
当修改 obj.foo 时,effectFn1 会执行。由于 effectFn1 里面也有一个 effect,所以当执行了 effectFn1 时,毫无疑问也会触发 effectFn2 的执行。
当修改 obj.bar 时,我们希望只有 effectFn2 会执行。
但是结果并不是这样的,比如尝试修改 obj.foo:
js1obj.foo = false
结果为:
bash1effectFn1 执行
2effectFn2 执行
3effectFn2 执行
前两个结果是 effectFn1 第一次执行后产生的正常输出,问题出在第三个输出。当修改 obj.foo 后,effectFn1 并没有执行,反而仅仅执行了 effectFn2。
仔细思考一下问题所在:
-
当执行 effect 时,effectFn1 会被包裹在 effectFn 里,此时 activeEffect 是 effectFn1 的包裹函数。然后调用 effectFn1
-
打印 effectFn1 执行
-
进入第二层 effect 执行逻辑,调用 effectFn2。此时 effectFn2 会被包裹在 effectFn 里并赋值给 activeEffect。
-
打印 effectFn2 执行
-
在 effectFn 内部发现 obj.bar 被访问,进入 get 拦截, activeEffect 作为 effectFn2 会被收集到桶里。
data ├─ bar ─ effectFn2
-
effectFn2 执行结束后,发现 obj.foo 被访问,此时走 get 拦截,activeEffect 并没有变化!
通过分析定位到问题就出在 activeEffect 上,它作为全局的变量,在内层 effect 执行后会将原来保存的值给覆盖掉,并且不会被恢复。外层的 obj.foo 被拦截后,依赖只能收集到内层的副作用函数。
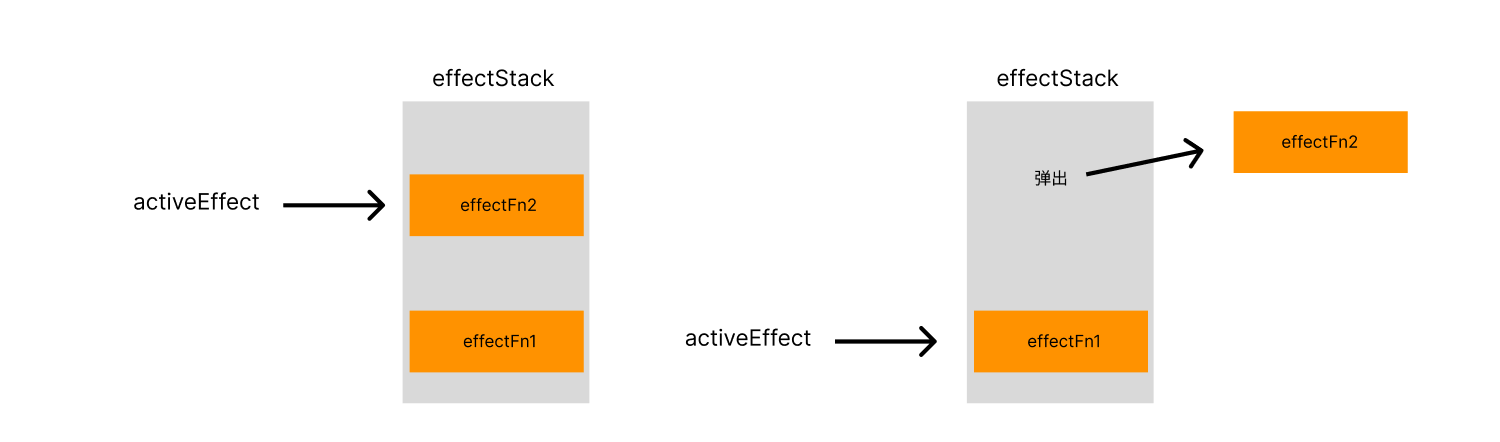
解决的方法是巧妙利用函数执行时的调用栈原理,将 activeEffect 变成一个栈,遇到嵌套 effect 时,activeEffect 就从外到内不断 push。在 bucket 收集副作用函数时,就从后面挨个弹出来,这样就做到了收集正确的副作用函数。
js1// let activeEffect
2let effectStack = []
3function effect(fn) {
4  const effectFn = () => {
5    cleanup(effectFn)
6    // 将副作用函数压入栈中
7    effectStack.push(effectFn)
8    fn()
9  }
10  // activeEffect.deps用来存储所有与该副作用函数相关联的依赖集合
11  effectFn.deps = []
12  effectFn()
13}
js1function track(target, key) {
2  // 从桶里取得以当前对象为 key 的 depsMap,这是一个 Map 类型
3  let depsMap = bucket.get(target)
4  // 如果 bucket 里面找不到  那么就新建一个Map 并与 target 关联
5  if (!depsMap) {
6    bucket.set(target, (depsMap = new Map()))
7  }
8  // 根据 key 从 depsMap 中取得 deps
9  let deps = depsMap.get(key)
10  // 如果没有则新建一个 set 类型
11  if (!deps) {
12    depsMap.set(key, (deps = new Set()))
13  }
14  // 从effect栈的最后一位中拿出当前执行的副作用函数赋值给activeEffect
15  const activeEffect = effectStack.pop()
16  // 将当前激活的副作用函数添加到桶里
17  deps.add(activeEffect)
18  // deps就是一个与当前副作用函数存在联系的依赖集合
19  activeEffect.deps.push(deps)
20}
此外,为了遵循最小修改原则,还有一个仅修改 effect 函数内代码的处理方法:
diff1let activeEffect;
2+ let effectStack = [];
3function effect(fn) {
4  const effectFn = () => {
5    cleanup(effectFn);
6    // 当 effectFn 执行时,将activeEffect设置为当前激活的副作用函数
7    activeEffect = effectFn;
8+    // 在调用副作用函数之前将当前副作用函数保存入effectStack 中
9+    effectStack.push(effectFn);
10    fn();
11+    // 在副作用函数执行之后将 effectFn 弹出,并把 activeEffect 还原成之前的值
12+    effectStack.pop();
13+    activeEffect = effectStack[effectStack.length - 1];
14  };
15  // activeEffect.deps用来存储所有与该副作用函数相关联的依赖集合
16  effectFn.deps = [];
17  effectFn();
18}
当内层副作用函数 effectFn2 执行后,副作用函数栈就把它弹出,并将存储在栈顶的 effectFn1 设置为 activeEffect
1.6 避免无限递归循环
现在我们的响应式系统已经能够正常收集嵌套依赖了。但依然要考虑到诸多细节,比如:
js1effect(function effectFn1() {
2  obj.foo = !obj.foo
3})
这段代码会造成无限递归循环。
bash1Maximum call stack size exceeded
原因是这段代码又读取了 obj.foo 的值,又设置了 obj.foo 的值。
当读取操作时,我们会收集依赖。
当设置操作时,我们会执行收集到的依赖。
于是上面代码就在不断自己收集和自己执行中进入了无限递归循环。
通过分析可以发现,收集时的 effectFn 是 activeEffect,触发时的 effectFn 也是 activeEffect。所以解决的方法是在 trigger 动作发生时增加守卫条件:如果 trigger 触发执行的副作用函数与当前正在执行的副作用函数相同,则不触发执行。
js1function trigger(target, key) {
2  // 根据 target 从桶里取出 depsMap
3  const depsMap = bucket.get(target)
4  if (!depsMap) return
5  // 再根据 key 从 depsMap 中取得注册的所有副作用函数列表
6  const effects = depsMap.get(key)
7  const newEffects = new Set()
8  effects.forEach((effectFn) => {
9    // 如果 trigger 触发执行的副作用函数与当前执行的副作用函数相同,则不触发执行
10    if (effectFn !== activeEffect) {
11      newEffects.add(effectFn)
12    }
13  })
14  newEffects.forEach((effectFn) => effectFn())
15  // effects && effects.forEach((effectFn) => effectFn());
16}
1.7 调度执行
可调度指的是当 trigger 动作触发副作用函数重新执行时,有能力决定副作用函数执行的时机、次数和方式。
比如以下代码:
js1effect(function effectFn1() {
2  console.log(obj.foo)
3})
4
5obj.foo = false
6console.log('结束了')
执行结果:
bash1true
2false
3结束了
现在我们需要增加调度器,在不调整代码的情况下让代码的执行顺序变为:
bash1true
2结束了
3false
为了实现这个需求,我们需要让响应系统支持调度。
可以给 effect 函数设计一个选项参数 options,允许用户指定调度器。
js1effect(
2  () => {
3    console.log(obj.foo)
4  },
5  // options
6  {
7    scheduler(fn) {
8      //...
9    },
10  },
11)
如上所述,用户在调用 effect 注册副作用函数时,可以通过第二个参数 options 来指定 scheduler。同时在 effect 函数内部我们需要将 options 选项挂载到对应的副作用函数上。
js1function effect(fn, options) {
2  const effectFn = () => {
3    cleanup(effectFn)
4    activeEffect = effectFn
5    effectStack.push(effectFn)
6    fn()
7    // 当 effectFn 执行时,将其设置为当前激活的副作用函数
8    effectStack.pop()
9    activeEffect = effectStack[effectStack.length - 1]
10  }
11  // activeEffect.deps用来存储所有与该副作用函数相关联的依赖集合
12  effectFn.deps = []
13  // 将 options 挂载到 effectFn 上
14  effectFn.options = options
15  effectFn()
16}
有了调度函数,我们在 trigger 函数中触发副作用函数重新执行时,可以调用用户传入的调度器函数,从而把控制权交给用户:
js1function trigger(target, key) {
2  // 根据 target 从桶里取出 depsMap
3  const depsMap = bucket.get(target)
4  if (!depsMap) return
5  // 再根据 key 从 depsMap 中取得注册的所有副作用函数列表
6  const effects = depsMap.get(key)
7  const newEffects = new Set()
8  effects.forEach((effectFn) => {
9    // 如果 trigger 触发执行的副作用函数与当前执行的副作用函数相同,则不触发执行
10    if (effectFn !== activeEffect) {
11      newEffects.add(effectFn)
12    }
13  })
14  newEffects.forEach((effectFn) => {
15    // 如果副作用函数中存在 options.scheduler,则调用该函数。并将 effectFn 作为参数传递
16    if (effectFn.options.scheduler) {
17      // 新增
18      effectFn.options.scheduler(effectFn) // 新增
19    } else {
20      effectFn() // 新增
21    }
22  })
23}
如上述代码所示,在 trigger 函数执行副作用函数时,我们优先判断该副作用函数中是否存在调度器,如果存在,则直接调用调度器,并将 effectFn 作为参数传递进去;如果不存在,则直接执行该副作用函数。
现在我们的代码已经支持自定义调用顺序了:
js1effect(() => console.log(obj.foo), {
2  scheduler(fn) {
3    setTimeout(fn)
4  },
5})
6obj.foo = false
7console.log('结束了')
结果为:
js1true
2结束了
3false
除了控制顺序外,还能通过调度器做到控制它的次数。比如以下例子:
js1let data = { foo: 1 };
2const obj = new Proxy(data,{...})
3effect(()=>{console.log(obj.foo)})
4obj.foo++
5obj.foo++
打印的结果是:
js11
22
33
由输出结果可以看到,obj.foo 最终会从 1 变成 3,2 只是它的过渡状态。如果我们只关心最终结果而不关心过程,那么执行三次打印是多余的,我们希望能够跳过第二次,直接从 1 变成 3:
js11
23
基于调度器,我们可以完成此功能,思路如下:
js1// 定义一个任务队列
2const jobQueue = new Set()
3// 创建一个 promise 实例,通过它将任务添加到微任务队列中,异步执行
4const p = Promise.resolve()
5// 一个标志,用来表示队列是否正在刷新队列
6let isFlushing = false
7function flushJob() {
8  // 如果队列正在刷新,则什么都不做
9  if (isFlushing) return
10  // 设置为 true,表示正在刷新
11  isFlushing = true
12  // 在微任务队列中刷新 jobQueue 队列
13  p.then(() => jobQueue.forEach((job) => job())).finally(() => {
14    // 结束后重置 isFlushing
15    isFlushing = false
16  })
17}
18
19effect(() => console.log(obj.foo), {
20  scheduler(fn) {
21    // 每次调度时,将副作用函数添加到 jobQueue 队列中
22    jobQueue.add(fn)
23    // 调用 flushJob 刷新队列
24    flushJob()
25  },
26})
27obj.foo++
28obj.foo++
整段代码的效果如下:
- 执行第一个
obj.foo++时,触发调度器,将 effectFn 的任务添加到jobQueue的任务队列中,并刷新队列 - 此时
flushJob会将isFlushing设置为true,代表正在刷新队列,然后p.then会将遍历队列的操作放到微任务队列中 - 继续执行
obj.foo++,继续触发调度器,将 effectFn 的任务添加到jobQueue的任务队列中。由于jobQueue是一个Set数据结构,具有自动去重的能力,所以jobQueue始终只有一个副作用函数,即当前副作用函数。 - flushJob 也会执行两次,但由于
isFlushing的存在,实际上flushJob在一个事件循环过程中只执行了一次,即在微任务队列中执行一次。 - 当微任务队列开始执行时,就会遍历
jobQueue中储存的副作用函数。由于jobQueue中只有一个副作用函数,所以只会执行一次。当它执行时,obj.foo 的值已经变成3了
上面的代码需要注意的细节有三点:
- 巧妙利用 Set 数据结构自动去重的能力,否则
jobQueue会遍历多次相同的effectFn - 利用
isFlushing标志,确保任务队列在一个周期内只会执行一次。 - 通过
p.then将整个刷新队列的函数放到微任务队列中。
整个功能有点类似于Vue.js 中连续修改多次响应式数据但只会更新一次,实际上 Vue内部实现了更完善的调度器,思路大体相同。
1.8 计算属性 computed 和 lazy
懒加载的 effect 意味着某些情况下,我们不希望 effect 函数立即执行,而是在它需要的时候才执行。如下面代码所示:
js1effect(() => console.log(obj.foo), {
2  // 制定了 lazy 选项,这个函数不会立即执行
3  lazy: true,
4})
有了这个选项,我们可以修改 effect 函数的实现逻辑了。
diff1function effect(fn, options={}) {
2  const effectFn = () => {
3    cleanup(effectFn);
4    activeEffect = effectFn;
5    effectStack.push(effectFn);
6    fn();
7    // 当 effectFn 执行时,将其设置为当前激活的副作用函数
8    effectStack.pop();
9    activeEffect = effectStack[effectStack.length - 1];
10  };
11  // activeEffect.deps用来存储所有与该副作用函数相关联的依赖集合
12  effectFn.deps = [];
13  // 将 options 挂载到 effectFn 上
14  effectFn.options = options;
15  // 只有lazy 为假时,才执行 effectFn
16+  if (!options.lazy) {
17+    effectFn();
18+  }
19+  return effectFn;
20}
通过判断,我们实现了让副作用函数不立即执行的功能。并且由于返回了 effectFn,所以我们可以拿到返回值,并手动执行该副作用函数。
js1const effectFn = effect(() => console.log(obj.foo), {
2  lazy: true,
3})
4
5effectFn()
如果我们把传递给 effect 的函数看做是一个 getter,那么这个 getter 函数可以返回任何值,例如:
js1const effectFn = effect(
2  // getter返回 obj.foo和 obj.bar的和
3  () => obj.foo + obj.bar,
4  {
5    lazy: true,
6  },
7)
8const value = effectFn()
为了实现这个目标,我们需要再修改一些 effectFn 的代码
diff1function effect(fn, options={}) {
2  const effectFn = () => {
3    cleanup(effectFn);
4    activeEffect = effectFn;
5    effectStack.push(effectFn);
6    // 将 fn 的结果储存在 res 中
7+   const res = fn();
8    effectStack.pop();
9    // 当 effectFn 执行时,将其设置为当前激活的副作用函数
10    activeEffect = effectStack[effectStack.length - 1];
11+   return res;
12  };
13  // activeEffect.deps用来存储所有与该副作用函数相关联的依赖集合
14  effectFn.deps = [];
15  // 将 options 挂载到 effectFn 上
16  effectFn.options = options;
17  // 只有lazy 为假时,才执行 effectFn
18  if (!options.lazy) {
19    effectFn();
20  }
21  return effectFn;
22}
通过代码我们可以看到,真正的副作用函数 fn 执行后的结果会被保存到 res 变量中,然后作为我们包装过的函数 effectFn的返回值。
上面我们已经实现了让副作用函数懒执行,并且能够拿到副作用函数的执行结果了。下面继续实现计算属性:
js1function computed(getter) {
2  const effectFn = effect(getter, {
3    lazy: true,
4  })
5  const obj = {
6    get value() {
7      return effectFn()
8    },
9  }
10  return obj
11}
首先我们定义一个 computed 函数,它接收一个 getter 函数作为参数,我们把 getter 函数作为副作用函数,用它创建一个 lazy 的 effect。computed 函数的执行会返回一个对象,该对象的 value 属性是一个访问器属性,只有当读取 value 的值时,才会执行 effectFn 并将其结果作为返回值返回。
我们可以用 computed 函数来创建一个计算属性:
js1let data = { foo: 1, bar: 2 }
2// ...省略代码
3const res = computed(() => obj.foo + obj.bar)
4console.log(res.value) //3
5console.log(res.value) //3
6console.log(res.value) //3
当前执行的懒加载函数做到了懒计算,也就是说,只有当我们读取res.value时,它才会进行计算并得到值。但是还没做到对值的缓存,即我们多次访问res.value的值,会导致 effectFn 进行多次计算,即使 obj.foo 和 obj.bar 的值并没有发生变化。
为了对值做缓存,我们需要修改 computed 函数的代码:
js1function computed(getter) {
2  // 保存上一次计算的值
3  let value
4  // dirty 标志,用来标识是否需要重新计算值,为 true 时表示需要重新计算
5  let dirty = true
6  const effectFn = effect(getter, {
7    lazy: true,
8  })
9  const obj = {
10    get value() {
11      // 只有 脏 时才计算值,并将得到的值缓存到 value 中
12      if (dirty) {
13        value = effectFn()
14        // 将 dirty 设置为 false,下一次访问直接使用缓存中 value 的值
15        dirty = false
16      }
17      return value
18    },
19  }
20  return obj
21}
上面的代码我们增加了两个变量,一个是用来保存结果的 value, 另一个是代表是否需要重新计算的dirty 变量。只有当 dirty 变量为 true 时,才会调用 effectFn 重新计算,否则则返回上次计算缓存的结果。这样无论我们访问多少次 obj.value,都只会在第一次访问时进行真正的计算,后续的访问都会直接返回缓存的 value 值。
然后我们需要补足一个逻辑:当 obj.foo或者 obj.bar 的值改变时,把 dirty 设置为 true,让 computed 重新计算。
diff1function computed(getter) {
2  // 保存上一次计算的值
3  let value;
4  // dirty 标志,用来标识是否需要重新计算值,为 true 时表示需要重新计算
5  let dirty = true;
6  const effectFn = effect(getter, {
7    lazy: true,
8    // 添加调度器,将 dirty 重置为 true
9+    scheduler() {
10+      dirty = true;
11+    }
12  });
13  const obj = {
14    get value() {
15      // 只有 脏 时才计算值,并将得到的值缓存到 value 中
16      if (dirty) {
17        value = effectFn();
18        // 将 dirty 设置为 false,下一次访问直接使用缓存中 value 的值
19        dirty = false;
20      }
21      return value;
22    }
23  };
24  return obj;
25}
我们给 effect 添加了 scheduler 调度器函数,它会在 getter 函数中所依赖的响应式数据变化时执行,这样我们在 scheduler 函数内将 dirty 重置为 false。当下一次访问res.value时,就会重新调用 effectFn 计算值。
现在我们设计的计算属性还有一个缺陷,它体现在当我们在另外一个 effect 中读取计算属性的值时:
js1const res = computed(() => obj.foo + obj.bar)
2effect(() => {
3  console.log(res.value)
4})
5obj.foo++
res 是一个计算属性,并且在另外一个 effect 的副作用函数中读取了 res.value。如果此时修改了 obj.foo 的值,我们期望副作用函数重新执行。就像 vue 中的 computed 属性发生变化后,会触发重新渲染一样。
但是目前的代码还做不到如此。
分析一下原因:
- computed 内部拥有自己的 effect,并且它是懒执行的。只有当真正读取计算属性时才会执行。
- 对于 getter 函数来说,它里面访问的响应式数据会把 computed 内部的 effect 收集作为依赖。
- 当计算属性被用于另外一个 effect 时,就会发生 effect 嵌套。外层的 effect 没有响应式数据收集。
我们可以手动调用 track 函数和 trigger 函数完成响应式数据的收集和触发工作:
diff1function computed(getter) {
2  // 保存上一次计算的值
3  let value;
4  // dirty 标志,用来标识是否需要重新计算值,为 true 时表示需要重新计算
5  let dirty = true;
6  const effectFn = effect(getter, {
7    lazy: true,
8    // 添加调度器,将 dirty 重置为 true
9    scheduler() {
10+      if (!dirty) {
11+        dirty = true;
12+        trigger(obj, "value");
13+      }
14    }
15  });
16  const obj = {
17    get value() {
18      // 只有 脏 时才计算值,并将得到的值缓存到 value 中
19      if (dirty) {
20        value = effectFn();
21        // 将 dirty 设置为 false,下一次访问直接使用缓存中 value 的值
22        dirty = false;
23      }
24+      track(obj, "value");
25      return value;
26    }
27  };
28  return obj;
29}
当读取计算属性时,我们手动调用 track 函数进行收集
当计算属性发生变化时,会触发调度器,此时调用 trigger 函数手动触发响应。
这时会建立这样的响应联系:
computed(obj)
├─ value
		├─ effectFn
1.9 watch 的实现原理
watch 本质上就是观测一个响应式数据,当数据发生变化时通知并执行相应的回调函数。
js1watch(obj, () => {
2  console.log('数据变了')
3})
4
5// 当修改响应数据的值,会执行回调函数
6obj.foo++
假设 obj 是一个响应数据,使用 watch 函数观测它,并传递一个回调函数,当修改响应式数据的值时,会触发该回调函数的执行。
watch 的本质是利用 effect 和 scheduler 选项:
js1effect(
2  () => {
3    console.log(obj.foo)
4  },
5  {
6    scheduler() {
7      // 当 obj.foo的值发生变化时,会触发 scheduler 函数的执行
8    },
9  },
10)
当响应式数据发生变化时,会触发副作用函数重新执行。如果 effect 存在 scheduler 选项,则会触发 scheduler 调度执行,而非直接触发副作用函数执行。其实 scheduler 函数就是一个回调函数,通过这一点可以实现 watch。
js1function watch(source, callback) {
2  effect(
3    () => {
4      console.log(source.foo)
5    },
6    {
7      scheduler() {
8        // 当 obj.foo的值发生变化时,会触发 scheduler 函数的执行
9        callback()
10      },
11    },
12  )
13}
我们可以这样使用:
js1let data = { foo: 1 };
2let obj = new Proxy(data, {...})
3...
4watch(obj, () => {
5  console.log("数据变了");
6});
7
8// 当修改响应数据的值,会执行回调函数
9obj.foo++;
结果为:
js1数据变了
上面的watch函数代码内部,我们硬编码了source.foo这个读取操作,所以只能对 foo 这个属性进行观测,我们需要一个更加通用的方法:
js1function watch(source, callback) {
2  effect(
3    () => {
4      traverse(source)
5    },
6    {
7      scheduler() {
8        // 当 obj.foo的值发生变化时,会触发 scheduler 函数的执行
9        callback()
10      },
11    },
12  )
13}
14
15function traverse(value, seen = new Set()) {
16  // 如果要读取的数据是原始值,或者已经被读取过了,那么什么都不做
17  if (typeof value !== 'object' || value === null || seen.has(value)) return
18  // 将数据添加到 seen 中,代表遍历地读取过了,避免循环引用引起的死循环
19  seen.add(value)
20  // 不考虑数组等其他数据结构
21  // 假设 value 是一个对象,使用 for..in遍历读取对象的每一个值,并递归调用traverse进行处理
22  for (const k in value) {
23    traverse(value[k], seen)
24  }
25  return value
26}
上面的代码主要是在 watch 内部的 effect 中调用 traverse 函数进行递归的读取操作,代替硬编码的方式,这样就可以读取到对象上的任意属性,从而当任意属性发生变化时都能够触发回调函数执行。
watch 函数除了可以观测响应式数据外,还可以接收一个 getter 函数
js1watch(()=>obj.foo,()=>console.log('obj.foo的值变了'))
传递给 watch 函数的不仅仅可以是一个 source 数据,还可以是一个函数,这个函数内部用户可以指定 watch 依赖哪些响应式数据,只有当这些数据变化时,才会触发回调函数的执行。如下代码可以实现这一个功能:
js1function watch(source, callback) {
2  let getter
3  if (typeof source === 'function') {
4    getter = source
5  } else {
6    getter = () => traverse(source)
7  }
8  effect(() => getter(), {
9    scheduler() {
10      // 当 obj.foo的值发生变化时,会触发 scheduler 函数的执行
11      callback()
12    },
13  })
14}
首先我们判断 source 的类型,如果是函数类型,说明用户直接传递 getter 函数,这时直接用用户的 getter 函数,否则则保留之前的做法,即调用 traverse 递归读取。如此就实现了自定义 getter 的功能。
此时,我们最后还需要完成在回调函数中获取新值和旧值的功能。
js1watch(
2  () => obj.foo,
3  (newValue, oldValue) => console.log(newValue, oldValue),
4)
如何获取新值和旧值呢?这就需要充分利用 effect 函数 lazy 选项:
js1function watch(source, callback) {
2  let getter
3  if (typeof source === 'function') {
4    getter = source
5  } else {
6    getter = () => traverse(source)
7  }
8  let newValue, oldValue
9  // 开启 lazy 选项,把返回值储存到 effectFn中以便后续调用
10  const effectFn = effect(() => getter(), {
11    lazy: true,
12    scheduler() {
13      // 当 obj.foo的值发生变化时,会触发 scheduler 函数的执行
14      newValue = effectFn()
15      // 将新值和旧值作为回调函数的参数
16      callback(newValue, oldValue)
17      // 更新旧值,不然下一次会得到错误的旧值
18      oldValue = newValue
19    },
20  })
21  // 手动调用副作用函数,拿到的值就是旧值
22  oldValue = effectFn()
23}
在上面的代码中,核心操作如下:
- 使用 lazy 选项创建一个懒执行的 effectFn
- 手动调用 effectFn 拿到 oldValue,即第一次执行得到的值
- 当变化发生并触发 scheduler 调度函数执行时,会重新调用 effectFn 并拿到新值,这样我们就拿到了 newValue 和 oldValue,传递给 callback 就可以了
- 用新值更新旧值:
oldValue = newValue;,否则在下次变更发生时会得到错误的旧值
1.10 立即执行的 watch 与回调执行时机
watch 本质上是对 effect 的二次封装,这一节就来实现立即执行的回调函数以及回调函数的执行时机。
默认情况下,一个 watch 的回调只会在响应式数据发生变化时才会执行:
js1watch(obj, () => {
2  console.log('变化了')
3})
在 vue 中可以通过选项参数 immediate来指定回调是否需要立即执行:
js1watch(
2  obj,
3  () => {
4    console.log('变化了')
5  },
6  {
7    // 回调函数会在 watch 创建时立即执行一次
8    immediate: true,
9  },
10)
当 immediate 选项存在并且为真时,回调函数会在该 watch 创建时立即执行一次。仔细思考就会发现,回调函数的立即执行与后续执行本质上没有差别,所以我们可以把 scheduler 调度函数封装为一个通用函数,分别在初始化时和变更时执行它。
js1function watch(source, callback, options = {}) {
2  let getter
3  if (typeof source === 'function') {
4    getter = source
5  } else {
6    getter = () => traverse(source)
7  }
8  let newValue, oldValue
9  // 提取出共同的逻辑为 job 函数
10  function job() {
11    // 当 obj.foo的值发生变化时,会触发 scheduler 函数的执行
12    newValue = effectFn()
13    // 将新值和旧值作为回调函数的参数
14    callback(newValue, oldValue)
15    // 更新旧值,不然下一次会得到错误的旧值
16    oldValue = newValue
17  }
18  const effectFn = effect(() => getter(), {
19    // 开启 lazy 选项,把返回值储存到 effectFn中以便后续调用
20    lazy: true,
21    // 使用 job 函数作为调度器函数
22    scheduler: job,
23  })
24
25  if (options.immediate) {
26    // 当immediate 为真时立即执行 job,从而触发回调执行
27    job()
28  } else {
29    // 手动调用副作用函数,拿到的值就是旧值
30    oldValue = effectFn()
31  }
32}
上面的代码将原先在 scheduler 中获取新值、执行回调、更新旧值的逻辑提取到 job 函数中,并且根据选项中是否存在 immediate 且为真时立即执行 job 函数以触发 callback 回调执行。
除了指定回调函数为立即执行之外,还可以通过其他选项参数来指定回调函数的执行时机,例如在 vue3.js 中可以通过 flush 选项来指定:
js1watch(
2  obj,
3  () => {
4    console.log('变化了')
5  },
6  {
7    // 调度函数需要将副作用函数放到微任务队列中,并等待 DOM 更新结束后执行
8    flush: 'post',
9  },
10)
flush 的逻辑跟控制调度执行时控制次数的逻辑差不多,在调度器函数内检测 options.flush 是否为“post”,如果是,则将 job 函数放到微任务队列中,从而实现异步延迟执行的效果。
js1function watch(source, callback, options = {}) {
2  let getter
3  if (typeof source === 'function') {
4    getter = source
5  } else {
6    getter = () => traverse(source)
7  }
8  let newValue, oldValue
9  function job() {
10    // 当 obj.foo的值发生变化时,会触发 scheduler 函数的执行
11    newValue = effectFn()
12    // 将新值和旧值作为回调函数的参数
13    callback(newValue, oldValue)
14    // 更新旧值,不然下一次会得到错误的旧值
15    oldValue = newValue
16  }
17  const effectFn = effect(() => getter(), {
18    // 开启 lazy 选项,把返回值储存到 effectFn中以便后续调用
19    lazy: true,
20    scheduler: () => {
21      //
22      if (options.flush === 'post') {
23        // 如果 flush 为 post 咋将 job 放到微任务队列中
24        const p = Promise.resolve()
25        p.then(job)
26      } else {
27        job()
28      }
29    },
30  })
31
32  if (options.immediate) {
33    job()
34  } else {
35    // 手动调用副作用函数,拿到的值就是旧值
36    oldValue = effectFn()
37  }
38}
如上述代码所示,我们在 scheduler 函数中判断选项中是否 flush 的值为 post,如果是,则放到微任务队列中执行,反之则是同步执行,这相当于“sync”的实现机制。
1.11 过期的副作用函数
日常工作中会遇到以下问题:
js1let finalData
2watch(obj, async () => {
3  // 发布并等待网络请求
4  const res = await fetch('post/xx')
5  // 将结果赋值给 data
6  finalData = res
7})
上面的代码中,我们使用 watch 观察 obj 数据的变化动态,一旦请求成功,则将结果赋值给 finalData 变量。
仔细想想这段代码可能会发生竞态问题:当我们第一次修改 obj 的值,会触发回调函数的执行,此时第一次网络请求,我们称之为 A。
在请求 A 返回之前,假设我们还对 obj 的对象进行了第二次修改,这会导致发送的第二次请求 B。此时请求 A 和请求 B 都在进行中。我们不能确定哪一个先返回。如果 B 先返回结果,那么最终会导致 finalData 的结果为 A 请求的结果。
第一次修改 obj ——> 发送请求 A
第二次修改 obj ——> 发送请求 B
B 先返回结果,则将 B 的结果赋值给 finalData
A 后返回结果,最终 A 的结果赋值给 finalData
但是由于请求 B 是后发送的,所以我们认为 B 应该是最新的数据,而请求 A 应该被认为是过期的,所以我们希望变量 finalData 存储的值应当是请求 B 返回的结果。
这个问题可以这样解决:请求 A 是副作用函数第一次执行的,请求 B 是副作用函数第二次执行的副作用。由于 B 请求的产生,请求 A 应当被视为过期的,其产生的结果应当视为无效。
我们需要一个能让副作用过期的功能。在 Vue.js 中,watch 函数的回调函数接收第三个参数 onInvalidate,它是一个函数。类似于事件监听器,我们可以使用 onInvalidate 函数注册一个回调,这个回调函数会在当前副作用函数过期时执行:
js1let finalData
2
3watch(obj, async (newValue, oldValue, onInvalidate) => {
4  // 定义一个标志,代表当前副作用函数是否过期,默认为 false,代表没有过期
5  let expired = false
6  // 用 onInvalidate 函数注册一个过期回调
7  onInvalidate(() => {
8    // 当过期时,将 expired 设置为 true
9    expired = true
10  })
11  const res = await fetch('post/xxx')
12  // 只有当该副作用函数的执行没有过期时,才会执行后续操作
13  if (!expired) {
14    finalData = res
15  }
16})
在上面的代码中,我们定义了 expired 标志,用来标志当前副作用函数是否过期;接着调用 onValidate 函数注册一个过期回调,当该副作用函数的执行过期时将 expired 设置为 true;最后只有当没有过期时才采用请求结果,这样就能够有效避免上述问题。
onValidate 的原理是每次当 watch 内部检测到变更后,在副作用执行重新执行之前,会先调用我们的 onInvalidate 函数注册的过期回调即可:
diff1function watch(source, callback, options = {}) {
2  let getter;
3  if (typeof source === "function") {
4    getter = source;
5  } else {
6    getter = () => traverse(source);
7  }
8  let newValue, oldValue;
9
10  // cleanup 用来存储用户注册的过期回调
11+  let cleanup;
12  // 定义 onValidate 函数
13+  function onValidate(fn) {
14+    cleanup = fn;
15+  }
16  function job() {
17    // 在调用 effectFn 之前,先调用过期回调
18+    if (cleanup) cleanup();
19    // 当 obj.foo的值发生变化时,会触发 scheduler 函数的执行
20    newValue = effectFn();
21    // 将新值和旧值作为回调函数的参数
22    // 将 onValidate 作为第三个参数,以供用户使用
23+    callback(newValue, oldValue, onValidate);
24    // 更新旧值,不然下一次会得到错误的旧值
25    oldValue = newValue;
26  }
27  const effectFn = effect(() => getter(), {
28    // 开启 lazy 选项,把返回值储存到 effectFn中以便后续调用
29    lazy: true,
30    scheduler: () => {
31      if (options.flush === "post") {
32        // 如果 flush 为 post 咋将 job 放到微任务队列中
33        const p = Promise.resolve();
34        p.then(job);
35      } else {
36        job();
37      }
38    }
39  });
40
41  if (options.immediate) {
42    job();
43  } else {
44    // 手动调用副作用函数,拿到的值就是旧值
45    oldValue = effectFn();
46  }
47}
- 在这段代码中,我们首先定义了 cleanup 变量,用来保存用户通过 onValidate 函数注册的函数。
- onValidate 函数的代码非常简单,仅仅是将注册的函数赋值给 cleanup 变量
- job 函数内,每次执行 callback 函数前,都先检测 cleanup 是否存在,即是否过期。如果存在,则调用 cleanup 函数
- 最后把 onValidate 函数传递给用户,供其使用
通过以下例子说明:
js1watch(obj, async (newValue, oldValue, onInvalidate) => {
2  let expired = false
3  onInvalidate(() => {
4    expired = true
5  })
6  const res = await fetch('post/xxx')
7  if (!expired) {
8    finalData = res
9  }
10})
11// 第一次修改
12obj.foo++
13setTimeout(() => {
14  // 200ms后做第二次修改
15  obj.foo++
16}, 200)
如上面的代码所示,会调用两次 obj.foo++,这也意味着 watch 的回调函数会触发两次:
- 第一次,执行回调函数,此时生成 expiredA = false,并且注册 onInvalidate 函数,发出请求并等待结果,假设 1000ms 后结果返回
- 200ms 后第二次回调函数执行,生成 expiredB = false。由于第一次 callback 的执行,闭包中的 cleanup 已经注册过了。所以在执行第二次 callback 之前,会调用 cleanup 中的函数
- 这样第一次执行回调时产生的 expiredA 就会变成 true,即副作用函数的执行过期了。
- 等第二次结果返回后,由于 expired 变成了 true,所以 res 的结果不会被赋值给 finalData,相当于将过期的结果给抛弃了
以下是简化的过程:
第一次修改 obj 的值 ——> 发送请求 A,expiredA = false
第二次修改 obj 的值 ——> 发送请求 B,expiredB=false,expiredA=true
请求 B 先返回,expiredB=false,expiredA=true。由于 expiredB 没有过期,将 B 的结果赋值给 finalData
请求 A 后返回,expiredB=false,expiredA=true,由于 expiredA 过期了,结果就被抛弃了
1.12 总结
-
请实现一个 effect 函数用来注册 effectFn,当数据改变时,就执行 effectFn 以自动更新页面
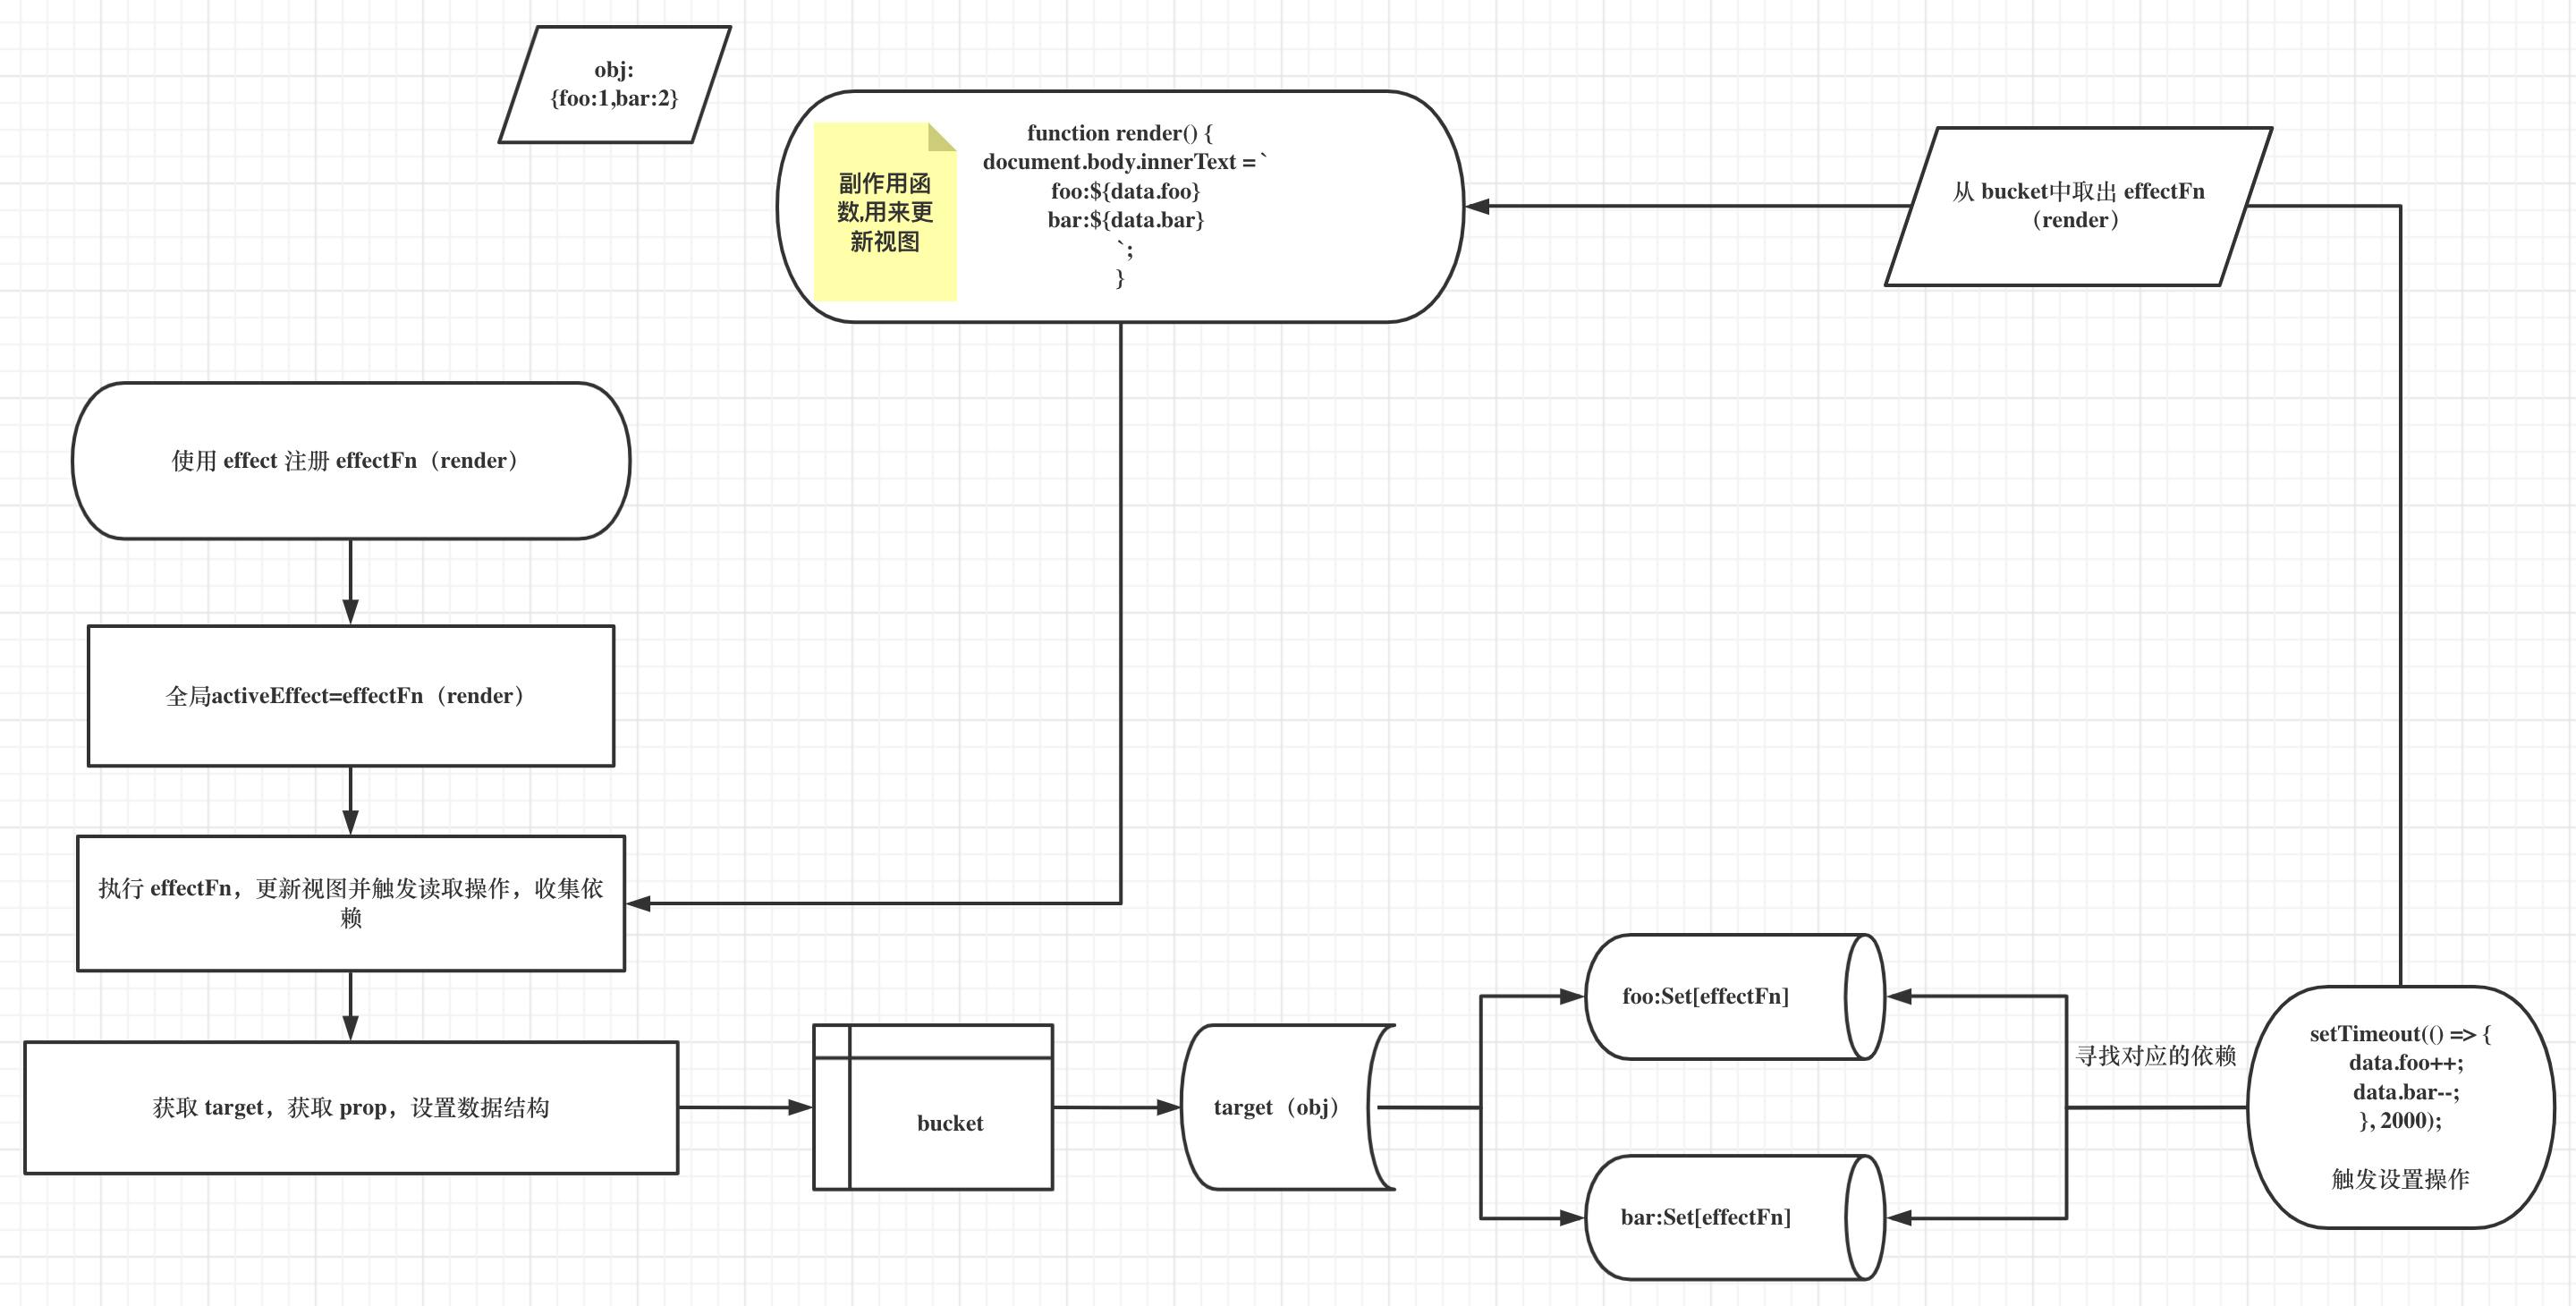
js1let obj = { foo: 1, bar: 2 }; 2 3let data = new Proxy(obj,...); 4 5function render() { 6 document.body.innerText = ` 7 foo:${data.foo} 8 bar:${data.bar} 9 `; 10} 11 12function effect(effectFn) { 13 // 当 obj 改变时自动执行副作用函数effectFn以渲染页面 14 // ...请完成代码 15} 16 17effect(render); 18 19setTimeout(() => { 20 data.foo++; 21 data.bar--; 22}, 2000); 23 24/* 25期待结果:2000ms 后 body 内容为: 26foo:2 27bar:1 28*/答案:https://codesandbox.io/s/1-jian-dan-de-xiang-ying-xi-tong-42ol5n?file=/src/index.js
-
分支切换问题
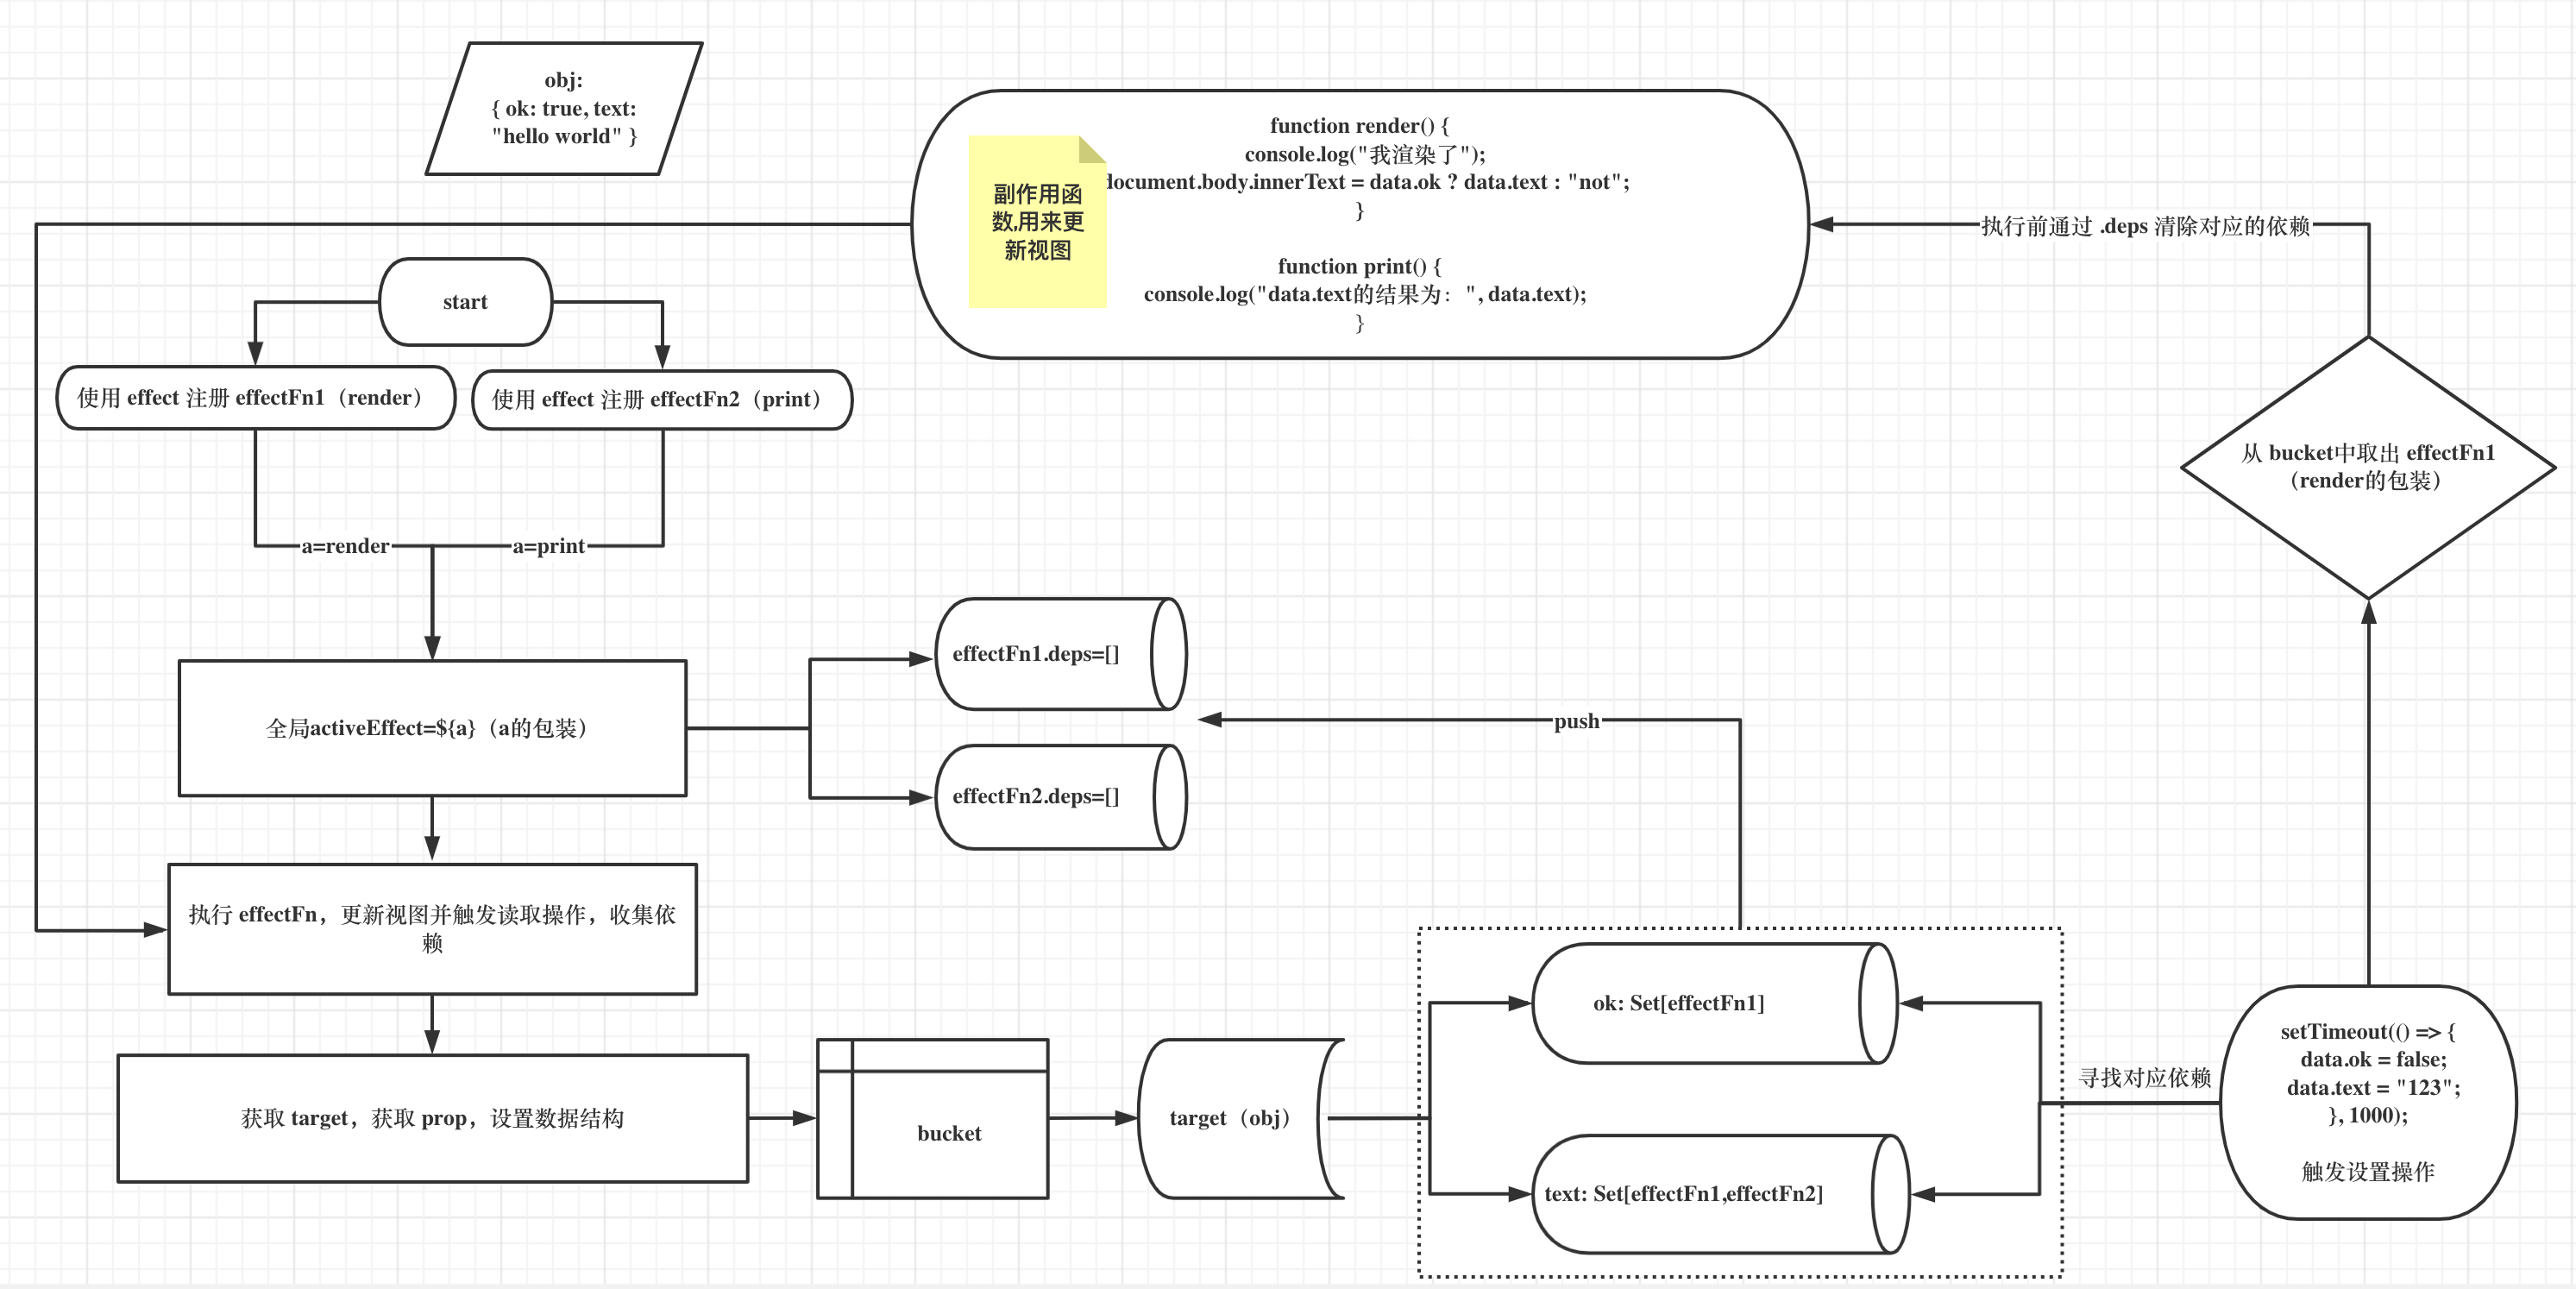
js1function render() { 2 console.log('我渲染了') 3 document.body.innerText = data.ok ? data.text : 'not' 4} 5 6function print() { 7 console.log('data.text的结果为:', data.text) 8} 9 10effect(render) 11effect(print) 12 13setTimeout(() => { 14 data.ok = false 15 data.text = '123' 16}, 1000) 17 18/* 19输出结果为: 20我更新视图了 21data.text的结果为: hello world 22我更新视图了 23我更新视图了 24data.text的结果为: 123 25*/effect接受的副作用函数 render 中的代码会根据字段obj.ok的变化来执行不同的分支。这就是分支切换。按照正确的逻辑,上面代码
render函数最多只执行两次。但现有代码却输出了三次“我更新视图了”,这是因为依赖中有遗留的副作用函数,请分析并解决这个问题
提示:你可以在问题 1 的答案基础上实现分支切换的功能
答案:https://codesandbox.io/s/2-fen-zhi-qie-huan-5xfhv6
-
嵌套的 effectFn 问题
js1effect(function effectFn1() {
2  console.log('effectFn1 执行')
3  effect(function effectFn2() {
4    console.log('effectFn2 执行')
5    temp2 = data.bar
6  })
7  temp1 = data.foo
8})
9
10data.foo = false
11
12/*
13输出结果为:
14effectFn1 执行
15effectFn2 执行
16effectFn2 执行
17*/
上面的代码是嵌套的 effect,由于是嵌套,所以当修改 data.foo 时,会重新执行 effectFn1 和 effectFn2 两个函数。即预想的结果为:
effectFn1 执行
effectFn2 执行
effectFn1 执行
effectFn2 执行
但是用前两题的答案的代码运行却输出了非预期结果,请分析并解决这个问题。
答案:https://codesandbox.io/s/3-qian-tao-de-effect-rcorx1?file=/src/index.js
-
无限循环问题
js1effect(() => {
2  console.log('我要被执行循环啦')
3  data.foo = !data.foo
4})
5
6effect(() => {
7  console.log('data.bar', data.bar)
8})
9data.bar = !data.bar
上面的代码会形成无限循环,请分析并解决。
答案:https://codesandbox.io/s/4-bi-mian-wu-xian-di-gui-xun-huan-o0leze?file=/src/index.js