 Oh-My-Note
【Diff 算法】
Diff 算法的规则
在 React 16.8 后的实现上,DIff 算法就是将 JSX 对象与 Current Fiber 节点做比较,然后根据对比结果构建出 workInProgress Fiber 节点。
React 官方文档reconciliation说道:
在某一时间节点调用 React 的
render()方法,会创建一棵由 React 元素组成的树。在下一次 state 或 props 更新时,相同的render()方法会返回一棵不同的树。React 需要基于这两棵树之间的差别来判断如何高效的更新 UI,以保证当前 UI 与最新的树保持同步。此算法有一些通用的解决方案,即生成将一棵树转换成另一棵树的最小操作次数。然而,即使使用最优的算法,该算法的复杂程度仍为 O(n 3 ),其中 n 是树中元素的数量。
如果在 React 中使用该算法,那么展示 1000 个元素则需要 10 亿次的比较。这个开销实在是太过高昂。于是 React 在以下两个假设的基础之上提出了一套 O(n) 的启发式算法:
- 两个不同类型的元素会产生出不同的树;
- 开发者可以使用
key属性标识哪些子元素在不同的渲染中可能是不变的。在实践中,我们发现以上假设在几乎所有实用的场景下都成立。
总结一下,React 的 O(n) 启发式算法是这样的:
-
当根节点为不同类型的元素时,React 会拆卸原有的树并且建立起新的树。(这时候不走 diff 流程)
用代码表示是这样的:
js1<div>
2  <Counter />
3</div>
4// 变成了
5<span>
6  <Counter />
7</span>
React 会销毁
Counter组件和div组件并且重新装载一个新的组件。 -
当对比两个相同类型的 React 元素时,React 会保留 DOM 节点,仅比对及更新有改变的属性。
js1<div className="before" title="stuff" />
2
3<div className="after" title="stuff" />
通过对比上面两个元素,会发现仅有 className 变化了,于是仅更新该 DOM 节点的 className
-
对子节点进行递归
默认情况下,当递归 DOM 节点的子元素时,React 会同时遍历两个子元素的列表;当产生差异时,生成一个 mutation。
在子元素列表末尾新增元素时,更新开销比较小。比如:
js1<ul>
2  <li>first</li>
3  <li>second</li>
4</ul>
5
6<ul>
7  <li>first</li>
8  <li>second</li>
9  <li>third</li>
10</ul>
React 会先匹配两个
<li>first</li>对应的树,然后匹配第二个元素<li>second</li>对应的树,最后插入第三个元素的<li>third</li>树。如果只是简单的将新增元素插入到表头,那么更新开销会比较大。比如:
js1<ul>
2  <li>Duke</li>
3  <li>Villanova</li>
4</ul>
5
6<ul>
7  <li>Connecticut</li>
8  <li>Duke</li>
9  <li>Villanova</li>
10</ul>
React 并不会意识到应该保留
<li>Duke</li>和<li>Villanova</li>,而是会重建每一个子元素。这种情况会带来性能问题。 -
如果开发者用 key 标识的话,相同的 key 能够让 React 识别并尽可能地复用它。
js1<ul>
2  <li key="2015">Duke</li>
3  <li key="2016">Villanova</li>
4</ul>
5
6<ul>
7  <li key="2014">Connecticut</li>
8  <li key="2015">Duke</li>
9  <li key="2016">Villanova</li>
10</ul>
现在 React 知道只有带着
'2014'key 的元素是新元素,带着'2015'以及'2016'key 的元素仅仅移动了。
以上总结是 React 为了方便开发者以及兼顾 Diff 更新性能所作出的规则,依据规则,就能写出性能更好的 React app。
从上面的介绍可以看出,Diff 算法分别考虑了子元素为多个以及子元素为 1 个(或 0 个)的处理情况。
这也就引出了多元素和单元素的 Diff 算法的不同处理方式。
单元素 Diff 算法
单元素的 Diff 指的是 React 对新的单元素和旧的单元素之间的数据比对。
js1// before
2<div>
3  123
4</div>
5// after
6<div>
7  456
8</div>
上面的 div 元素就是一个单元素。
React 对于单元素会进行以下步骤处理:
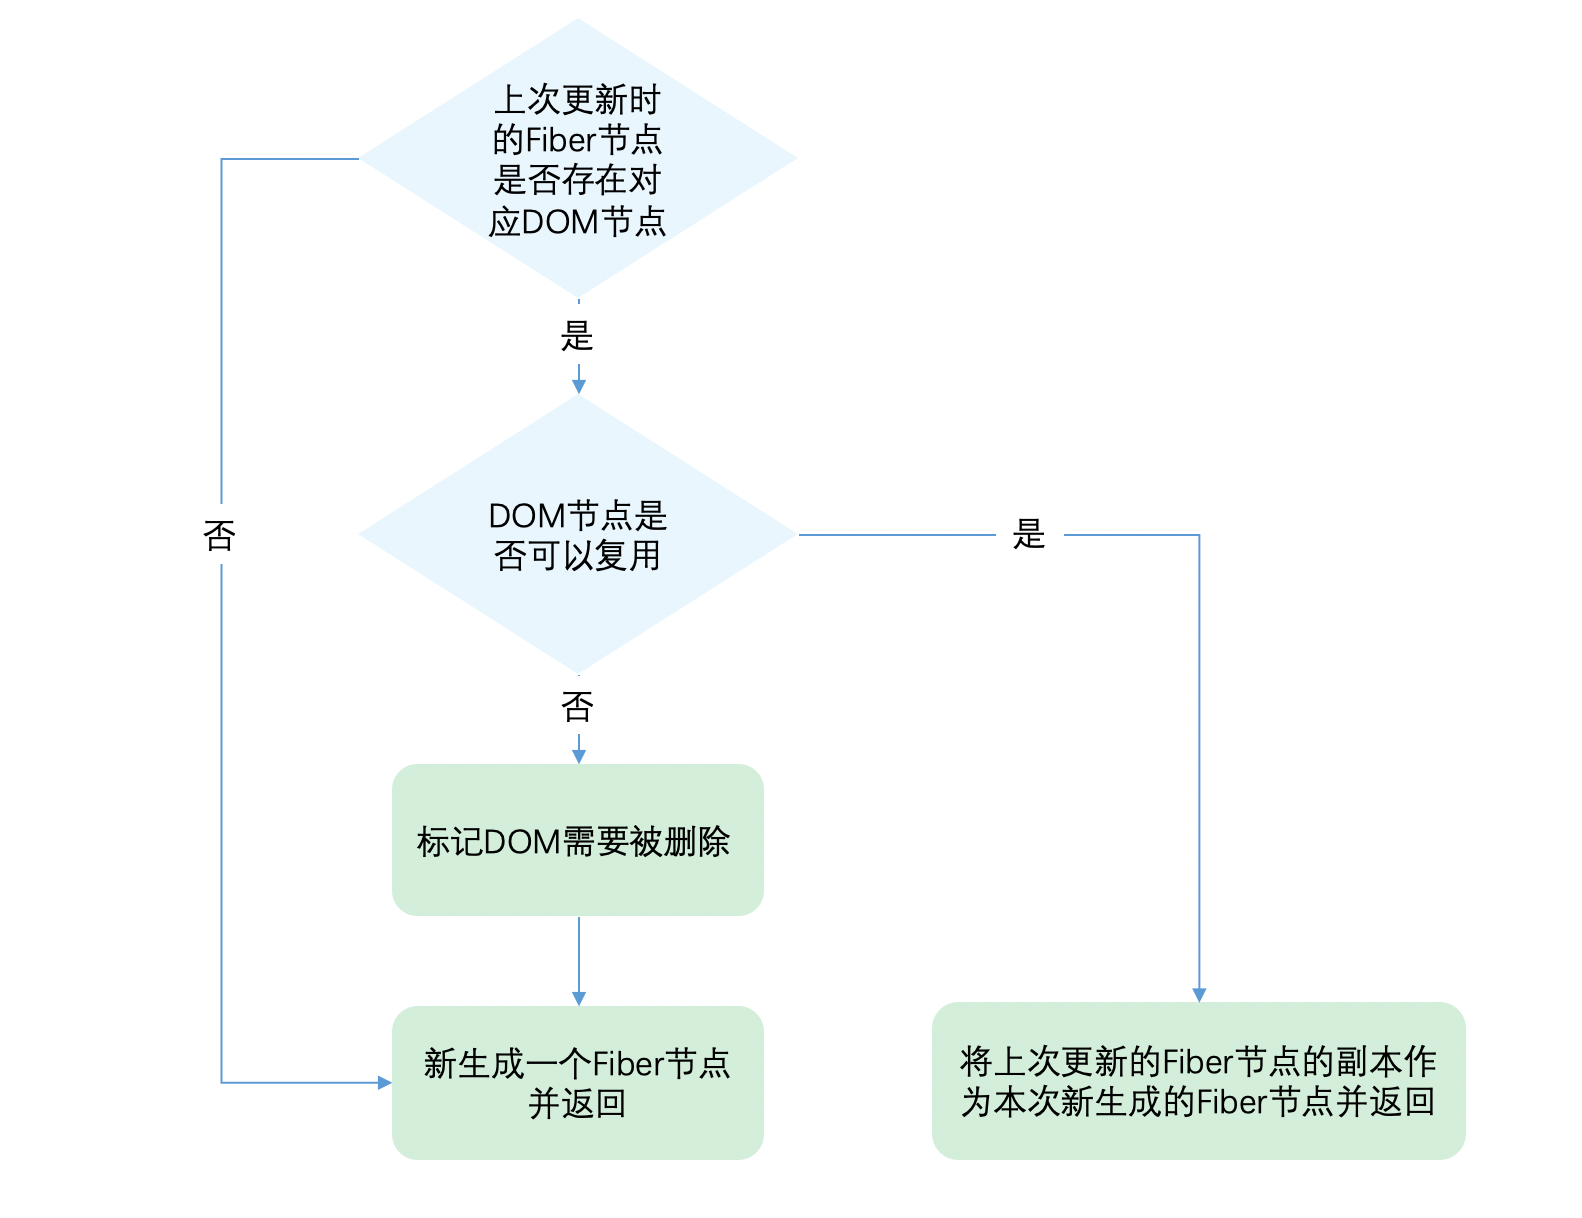
在 React 源码中,有一个reconcileSingleElement函数,这个函数就是用来处理单元素。
它接受四个参数并返回一个 Fiber 数据结构:
js1  function reconcileSingleElement(
2    returnFiber: Fiber,
3    currentFirstChild: Fiber | null,
4    element: ReactElement,
5    lanes: Lanes,
6  ): Fiber
其中第二个参数指的是 currentFiber 节点,第三个参数element 是 JSX 返回的对象。
当ReactDOM.render首次挂载组件时,此时只有 RootFIber ,workInProgress 还没有完整的 Fiber 节点,所以会执行createFiberFromElement方法创建 Fiber 节点。
当触发 update 更新时,element 与 currentFiber 做比较,最终生成 workInProgress Fiber。
那么判断节点是否可以复用的根据是什么呢?
要想复用有两个前提:
- 节点的 tag 是否相同
- 节点的 key 是否相同
以下面的 React 元素为例:
js1// before
2<div>
3  123
4</div>
5// after
6<div>
7  456
8</div>
在更新前,它的 tag 是div。更新后, tag 依然是div。
在更新前,它的key是undefined。更新后,key依然是undefined。
所以它满足复用的条件。
具体的判断逻辑代码是这样的:
js1function reconcileSingleElement(returnFiber: Fiber, currentFirstChild: Fiber | null, element: ReactElement): Fiber {
2  const key = element.key
3  let child = currentFirstChild
4
5  // 首先判断是否存在对应DOM节点
6  while (child !== null) {
7    // 上一次更新存在DOM节点,接下来判断是否可复用
8
9    // 首先比较key是否相同
10    if (child.key === key) {
11      // key相同,接下来比较type是否相同
12
13      switch (child.tag) {
14        // ...省略case
15
16        default: {
17          if (child.elementType === element.type) {
18            // type相同则表示可以复用
19            // 返回复用的fiber
20            const existing = useFiber(child, element.props)
21            // ...省略部分代码
22            return existing
23          }
24
25          // type不同则跳出switch
26          break
27        }
28      }
29      // 代码执行到这里代表:key相同但是type不同
30      // 将该fiber及其兄弟fiber标记为删除
31      deleteRemainingChildren(returnFiber, child)
32      break
33    } else {
34      // key不同,将该fiber标记为删除
35      deleteChild(returnFiber, child)
36    }
37    child = child.sibling
38  }
39
40  // 创建新Fiber,并返回 ...省略
41}
可以看出reconcileSingleElement方法主要是在 while 循环中做switch 判断:
先判断 key 是否相同,如果 key 相同则判断 type 是否相同,只有都相同时才会走复用的逻辑。
当可以复用时,会进入 useFiber 方法,这个方法会根据 current Fiber 返回克隆后的新的 Fiber 节点。
js1function useFiber(fiber: Fiber, pendingProps: mixed): Fiber {
2  // We currently set sibling to null and index to 0 here because it is easy
3  // to forget to do before returning it. E.g. for the single child case.
4  const clone = createWorkInProgress(fiber, pendingProps)
5  clone.index = 0
6  clone.sibling = null
7  return clone
8}
此外有个细节:
- 当
child !== null且key相同且type不同时执行deleteRemainingChildren将child及其兄弟fiber都标记删除。 - 当
child !== null且key不同时仅将child标记删除。
这个代码适用于以下情况:
当前页面有 3 个li,我们要全部删除,再插入一个p。
js1// 当前页面显示的
2ul > li * 3
3
4// 这次需要更新的
5ul > p
由于本次更新时只有一个p,属于单一节点的Diff,会走reconcileSingleElement逻辑。
在reconcileSingleElement中遍历之前的 3 个fiber(对应的DOM为 3 个li),寻找本次更新的p是否可以复用之前的 3 个fiber中某个的DOM。
当key相同且type不同时,代表我们已经找到本次更新的p对应的上次的fiber,但是p与li type不同,不能复用。既然唯一的可能性已经不能复用,则剩下的fiber都没有机会了,所以都需要标记删除——调用 deleteRemainingChildren方法。
当key不同时只代表遍历到的该fiber不能被p复用,后面还有兄弟fiber还没有遍历到。所以仅仅标记该fiber删除——调用deleteChild方法。
多元素 Diff 算法
多元素 Diff 算法是 React 对同级的多个元素,更新前和更新后之间对比。
比如以下情况:
js1// 更新前
2
3ul > li * 3
4
5//更新后
6
7ul > li * 4
ul 对象中的children属性是一个数组,数组中是同级的li元素的虚拟 DOM 描述。
数据结构类似于这样:
js1{
2  $$typeof: Symbol(react.element),
3  key: null,
4  props: {
5    children: [
6      {$$typeof: Symbol(react.element), type: "li", key: "", ref: null, props: {…}, …}
7      {$$typeof: Symbol(react.element), type: "li", key: "", ref: null, props: {…}, …}
8      {$$typeof: Symbol(react.element), type: "li", key: "", ref: null, props: {…}, …}
9      {$$typeof: Symbol(react.element), type: "li", key: "", ref: null, props: {…}, …}
10    ]
11  },
12  ref: null,
13  type: "ul"
14}
同级的 li 就属于多元素,更新前和更新后的li之间的对比就是多元素 Diff 算法。
多元素 Diff 算法有以下情况:
-
节点更新
html1// 之前 2<ul> 3 <li key="0" className="before">0</li> 4 <li></li> 5 <li key="1">1</li> 6 <li></li> 7</ul> 8 9// 之后 情况1 —— 节点属性变化 10<ul> 11 <li key="0" className="after">0</li> 12 <li></li> 13 <li key="1">1</li> 14 <li></li> 15</ul> 16 17// 之后 情况2 —— 节点类型更新 18<ul> 19 <div key="0">0</div> 20 <li key="1">1</li> 21 <li></li> 22</ul> -
节点数量发生变化
html1// 之前 2<ul> 3 <li key="0">0</li> 4 <li></li> 5 <li key="1">1</li> 6 <li></li> 7</ul> 8 9// 之后 情况1 —— 新增节点 10<ul> 11 <li key="0">0</li> 12 <li></li> 13 <li key="1">1</li> 14 <li></li> 15 <li key="2">2</li> 16 <li></li> 17</ul> 18 19// 之后 情况2 —— 删除节点 20<ul> 21 <li key="1">1</li> 22 <li></li> 23</ul> -
节点位置发生变化
html1// 之前
2<ul>
3  <li key="0">0</li>
4  <li></li>
5  <li key="1">1</li>
6  <li></li>
7</ul>
8
9// 之后
10<ul>
11  <li key="1">1</li>
12  <li></li>
13  <li key="0">0</li>
14  <li></li>
15</ul>
除了第 3 种情况,其他两种情况是采用 index 来对比前后的的节点发生了哪些变化——新增、删除或者更新属性。如果发生删除,该 Fiber 节点会被打上 DELETION 标记。
对于第 3 种情况,React 采用 key 标识节点。React 将 oldFiber 存入以 key 为 key,fiber 结构为 value 的 map 数据结构中,通过这个 map 来查找缓存中的 oldFiber。
这里有个好理解的 DEMO
js1// 之前
2abcd
3
4// 之后
5acdb
6
7===第一轮遍历开始===
8a(之后)vs a(之前)
9key不变,可复用
10此时 a 对应的oldFiber(之前的a)在之前的数组(abcd)中索引为0
11所以 lastPlacedIndex = 0;
12
13继续第一轮遍历...
14
15c(之后)vs b(之前)
16key改变,不能复用,跳出第一轮遍历
17此时 lastPlacedIndex === 0;
18===第一轮遍历结束===
19
20===第二轮遍历开始===
21newChildren === cdb,没用完,不需要执行删除旧节点
22oldFiber === bcd,没用完,不需要执行插入新节点
23
24将剩余oldFiber(bcd)保存为map
25
26// 当前oldFiber:bcd
27// 当前newChildren:cdb
28
29继续遍历剩余newChildren
30
31key === c 在 oldFiber中存在
32const oldIndex = c(之前).index;
33此时 oldIndex === 2;  // 之前节点为 abcd,所以c.index === 2
34比较 oldIndex 与 lastPlacedIndex;
35
36如果 oldIndex >= lastPlacedIndex 代表该可复用节点不需要移动
37并将 lastPlacedIndex = oldIndex;
38如果 oldIndex < lastplacedIndex 该可复用节点之前插入的位置索引小于这次更新需要插入的位置索引,代表该节点需要向右移动
39
40在例子中,oldIndex 2 > lastPlacedIndex 0,
41则 lastPlacedIndex = 2;
42c节点位置不变
43
44继续遍历剩余newChildren
45
46// 当前oldFiber:bd
47// 当前newChildren:db
48
49key === d 在 oldFiber中存在
50const oldIndex = d(之前).index;
51oldIndex 3 > lastPlacedIndex 2 // 之前节点为 abcd,所以d.index === 3
52则 lastPlacedIndex = 3;
53d节点位置不变
54
55继续遍历剩余newChildren
56
57// 当前oldFiber:b
58// 当前newChildren:b
59
60key === b 在 oldFiber中存在
61const oldIndex = b(之前).index;
62oldIndex 1 < lastPlacedIndex 3 // 之前节点为 abcd,所以b.index === 1
63则 b节点需要向右移动
64===第二轮遍历结束===
65
66最终acd 3个节点都没有移动,b节点被标记为移动
67